Die ganze Wissensbasis in einer Datei

Urna speichert Texte, Bilder und Referenzen, schon in Vektoren umgewandelt, in einer einzigen .urna. Deine App kopiert diese Datei und beantwortet Fragen mit Quellenangabe, ohne Server, ohne Internet und ohne API-Key.
v0.5.1 · Open Source unter MIT · Rust + Python
.csv
.jsonl
.sqlite
.jpg
Island
Basic Land · Island
corpus/
01001001 01110011 01101100 01100001 01101110 01100100IslandBasic Land · Island256 Zahlen pro Chunk, von potion
corpus.toml
[source] kind = "sqlite"
[[models]] preset = "potion"
[[models]] preset = "clip-vit-b32"
Island
JPEGAV1
Basic Land · Island
JPEGAV1
103 kB → 13 kBSchnitt pro KarteJPEG, Quelle · AV1, in der Datei
Drift p50 0,961
Karten-Scans4 GB
.urna533 MB
kleiner
100 % von exact61 % von exact34 % von exact26 % von exact21 % von exact
model_hashclip-vit-b32
HNSW + BM25 → cosine
Island
Forest
Mountain
p50, Text zu Bild
Island
Basic Land · Island
urna validateHeaderSektionenDateiInhalt
Die Runtime öffnet nie einen Socket

Ein Ordner und ein paar Zeilen TOML werden zu einer einzigen .urna: Chunks, Vektoren, Index, Medien und Manifest, jede Sektion signiert.

Die Karten-Scans kommen als AV1 in die Datei, die Vektoren wechseln auf ein kleineres Preset. Die Datei schrumpft, das Zitat bleibt gleich.

Das model_hash-Gate prüft das Modell, HNSW läuft durch den Graphen, BM25 findet das Wort und der exakte Kosinus legt die Reihenfolge fest.

Die Antwort trägt ein Zitat zurück zur Quelle, und urna validate prüft jede Schicht vor der ersten Anfrage, offline.

so funktioniert es

Vom Ordner voller Dokumente
zur Datei, die antwortet

1
Quellen sammeln
Texte, PDFs, Tabellen, Bilder. In einer TOML-Datei mit ein paar Zeilen beschreibst du, woher was kommt und welches Modell es liest.
2
Die .urna erzeugen
Den Rest erledigt ein Aufruf: urna.build in Python oder urna build --spec aus einem Checkout des Repos. Er zerlegt alles in Chunks, berechnet die Vektoren, baut die Indizes und signiert jeden Abschnitt mit SHA-256. Heraus kommt eine einzige Datei, auf jeder Maschine Byte für Byte identisch.
3
Aus der App heraus fragen
Die Rust-Runtime öffnet die Datei per mmap und liefert die ähnlichsten Chunks, jeden mit einem urna://-Verweis, der zurück zum Originaltext führt.
Offen für Audits, wie jede Datenbank es sein sollte
Eigenständig, prüfbar, reproduzierbar, offline.
Die Datei ist die ganze Datenbank
Chunks, Vektoren, Indizes, Medien und Manifest in derselben .urna. Kopier sie wie eine SQLite-Datei, versionier sie in git, pack sie in den Installer. Kein Dienst, den du starten musst, kein Index, den du synchron halten musst.
Jede Antwort zeigt auf einen Chunk, den du prüfen kannst
Jeder Abschnitt hat einen SHA-256, die ganze Datei auch, und der dekodierte Inhalt ebenfalls. Der Verweis urna://content_hash/chunk_id bleibt derselbe, nachdem der Text komprimiert wurde, und urna cite löst ihn zum gespeicherten Chunk auf.
Offline, ohne Ausnahme
Die Runtime öffnet nie einen Socket. Das Standard-Textmodell liegt im Python-Paket, sonst lädt urna setup es einmal bei der Installation. Wenn das Modell der Anfrage nicht zu dem der Datei passt, bricht die Suche sofort ab, statt Müll zu liefern, der wie eine Antwort aussieht.
in der Praxis

Öffentlicher Benchmark, gleicher Maßstab

urna gegen usearch, hnswlib, sqlite-vec und lancedb, auf derselben Maschine, mit den Daten und dem Befehl zum Nachmessen
0,72 ms
p50
1,02 ms
p99
recall 1,0
0,72 ms pro Abfrage, Recall 1,0
100.000 Vektoren mit 384 Dimensionen, 200 Abfragen, ein Thread. Das Preset hybrid antwortete mit einem p50 von 0,72 ms und einem p99 von 1,02 ms. Urna ist die einzige Engine in der Tabelle, die vor der ersten Abfrage ihre eigenen Bytes prüft; das kostet beim Öffnen etwa 360 ms.
In der Doku ansehen: 0,72 ms pro Abfrage, Recall 1,0
38.000 Magic-Karten in 533 MB
Aus 4 GB JPEG-Scans wurde eine 7,46-mal kleinere Datei, mit Text, Vektoren, Index und den AV1-Bildern darin, und die Suche findet die Karte genauso oft wie in der Lossless-Datei.
In der Doku ansehen: 38.000 Magic-Karten in 533 MB
30.725
Chunks
7
Datasets
FakeRecogna11.900
Fake.br7200
FakeTrue.Br3600
factck-br1300
30.000 Chunks aus dem Faktencheck
truw bewertet Behauptungen auf Portugiesisch anhand von sieben öffentlichen Fake-News-Datasets. Der Korpus ist eine .urna mit 30.725 Chunks: 120 MB mit dem Preset exact, 31 MB mit tiny.
In der Doku ansehen: 30.000 Chunks aus dem Faktencheck

Benchmark vom 2026-09-10 auf arm64, Single Thread. Was Urna nicht kann: Update und Delete in place, Metadatenfilter, parallele Schreibzugriffe. Zur vollständigen Tabelle.

Benchmarks

Die Benchmarks von urna

Misst Kompression, Suche und Latenz auf den 38.627 Magic-Karten (3,98 GB JPEG) in einer .urna-Datei, und urna gegen usearch, hnswlib, sqlite-vec und lancedb auf denselben Vektoren und derselben Maschine

Kompression gegen Suche nach Name

7 Dateien · je 1.000 Abfragen
Kompressionsfaktor ohne Verlust bei der Suche7,46x

kleiner als die 3,98 GB JPEG-Quelldaten. Die Datei bei crf50 wiegt 533 MB und findet die Karte über den Namen so oft wie die Lossless-Datei mit 3,61 GB: txt@1 bei +0,001, innerhalb des Standardfehlers.

lossless · 3,61 GB
neardup · 1,37 GB
crf50 · 533 MB

Was diese Metrik misst

txt@1 ist der Anteil der 1.000 Abfragen, bei denen die richtige Karte auf Platz eins kam. Die Abfrage ist der Kartenname als Text ("artwork of the card {name}"), gesucht im Bildraum von clip: Das Modell sieht nur die Illustration, deshalb ist das Niveau in allen Dateien niedrig. Entscheidend ist, wo es abfällt.

Drift ist der Kosinus zwischen dem Vektor des komprimierten Bilds und dem des Originals: 1,00 heißt identisch, und je tiefer er fällt, desto mehr hat der Codec an dem verändert, was das Modell sieht. Das schlechteste Dezil (p10) ist die Karte am Rand der 10 %, die sich am stärksten verändert haben; der Median (p50) ist die Karte in der Mitte.

So liest du dieses Diagramm

Jede Spalte ist eine Datei mit denselben 38.627 Karten, von Lossless (3,61 GB) bis AV1 bei crf60 (230 MB), nach Kompression sortiert.

Oben fallen beide Drift-Linien durchgehend und unterschreiten den Gate-Floor schon bei der zweiten Datei. Unten bleibt die Suche bis crf50 flach: Die grünen Balken liegen innerhalb eines Standardfehlers von Lossless. Die gestrichelte Linie markiert, wo die Suche einbricht, und die roten Balken sind die Dateien danach.

DateiGrößedrift p10txt@1±1 Standardfehlerz vs Lossless
lossless3,61 GB0,99680,0920,00910,00
neardup1,37 GB0,96660,0960,00930,31
avif q481,2 GB0,96800,0960,00930,31
crf40981 MB0,95940,0890,0090-0,23
crf50533 MB0,93890,0930,00920,08
crf55370 MB0,92110,0740,0083-1,46
crf60230 MB0,88660,0690,0080-1,89

1.000 Abfragen pro Datei, in allen dieselben Karten; binomialer Standardfehler; z ist der Abstand von txt@1 jeder Datei zu Lossless in kombinierten Standardfehlern: Bis crf50 liegt keiner über 1.

gemessen am 2026-09-12 · benchmark/experiments/14-utility-ladder/results.json

Presets
Wähl die Größe. Der Inhalt bleibt gleich
Fünf Presets kombinieren Textkompression, Vektorpräzision und Indizes, dazu micro, das Dimensionen kürzt. Drei hier, alle in der Doku
Für Fragen mit Abkürzungen, Eigennamen, seltenen Begriffen:
Text mit zstd komprimiert
Vektoren in float32
HNSW + BM25 als Kandidaten
Rerank per exaktem Kosinus
Zum Preset
Gemessen an 30.725 Chunks. Der Recall misst hier, wie stabil das Ranking unter Quantisierung bleibt, nicht die Treffsicherheit bei echten Fragen. Alle fünf Presets und micro ansehen.
Integration
Installiert mit einem Befehl. Integriert in fünf Zeilen
Ein Rust-Binary mit drei Gruppen von Verben (engine, agent, setup) und eine Python-API. Nach der Installation läuft alles hier unten ohne Netz
$
Installieren
Installer
$
Bauen
urna build
$
Fragen
urna ask
Der Installer prüft den SHA-256, bevor er schreibt. urna setup lädt einmal den Offline-Embedder und endet mit urna doctor, der dir sagt, welche Ebene fehlgeschlagen ist, falls eine.
curl -sSf https://raw.githubusercontent.com/hoffresearch/urna/main/scripts/install.sh | sh urna setup
Quellen, Medien und Modell in einer TOML-Datei, ausgeführt in einem Checkout des Repos. Dieselbe Spec ergibt auf jeder Maschine dieselbe Datenbank.
urna build --spec corpus.toml
Zitierte Chunks, direkt im Terminal.
urna ask corpus.urna "funktioniert es offline?" -k 3
JSONL mit Chunk, Quelle, Score und Verweis, fertig für deine App oder deinen Agenten.
urna retrieve corpus.urna "funktioniert es offline?" -k 5 --format jsonl
Öffnet per mmap, liefert zitierte Treffer. Der erwartete model_hash stoppt ein falsches Modell vor der Suche.
import urna from urna.embed_potion import potion_embedder emb, db = potion_embedder(), urna.open("corpus.urna") qvec = emb.embed_texts(["funktioniert es offline?"])[0] hits = db.retrieve(qvec, 5, expected_model_hash=emb.model_hash())
Alle Checksummen vor dem Ausliefern: Header, Abschnitte, Datei, Inhalt.
urna validate corpus.urna
Vom Verweis zurück zum gespeicherten Text, mit den Hashes als Beleg.
urna cite corpus.urna "urna://content_hash/chunk_id"
Latenz und Recall auf deiner Maschine, mit deinem Korpus.
urna benchmark corpus.urna -q 100 -k 10 --ann 100
Kanäle

Ein Release, jeder Paketmanager

Dasselbe urna 0.5.1 auf crates.io, PyPI, npm und Homebrew, mit Checksumme und Attestation neben jeder Datei
Überall dasselbe Binary
cargo, pip, npm, bun, pnpm, yarn, brew, der curl-Einzeiler und PowerShell installieren denselben Build: macOS und Linux auf arm64 und x86_64, Windows auf x86_64. npx und uvx starten ihn, ohne etwas zu installieren.
In der Doku ansehen: Überall dasselbe Binary
tar.xz
zip
sha256
sigstore
SBOM
ssh tag
Ein Release, das man prüfen kann
Jedes Archiv hat seine eigene .sha256 und eine sigstore-Attestation, die gh attestation verify prüft, dazu ein CycloneDX-SBOM und Binaries, die mit cargo-auditable gebaut sind. Release-Tags sind per ssh signiert.
In der Doku ansehen: Ein Release, das man prüfen kann
In deiner App, ohne CLI
urna-format und urna-runtime liegen für Rust auf crates.io, und das Python-Paket öffnet dieselbe Datei. Im Repo gibt es Beispiele für fastapi, flask und jupyter und ein Dockerfile, und cargo install urna --no-default-features hinterlässt eine reine Engine-CLI mit 2,1 MB.
In der Doku ansehen: In deiner App, ohne CLI
Ohne Installationnpx @urna/cli validate corpus.urnauvx --from urna urna validate corpus.urnacargo binstall urna
im Terminal

Drei Gruppen von Verben und ein Bildschirm dafür
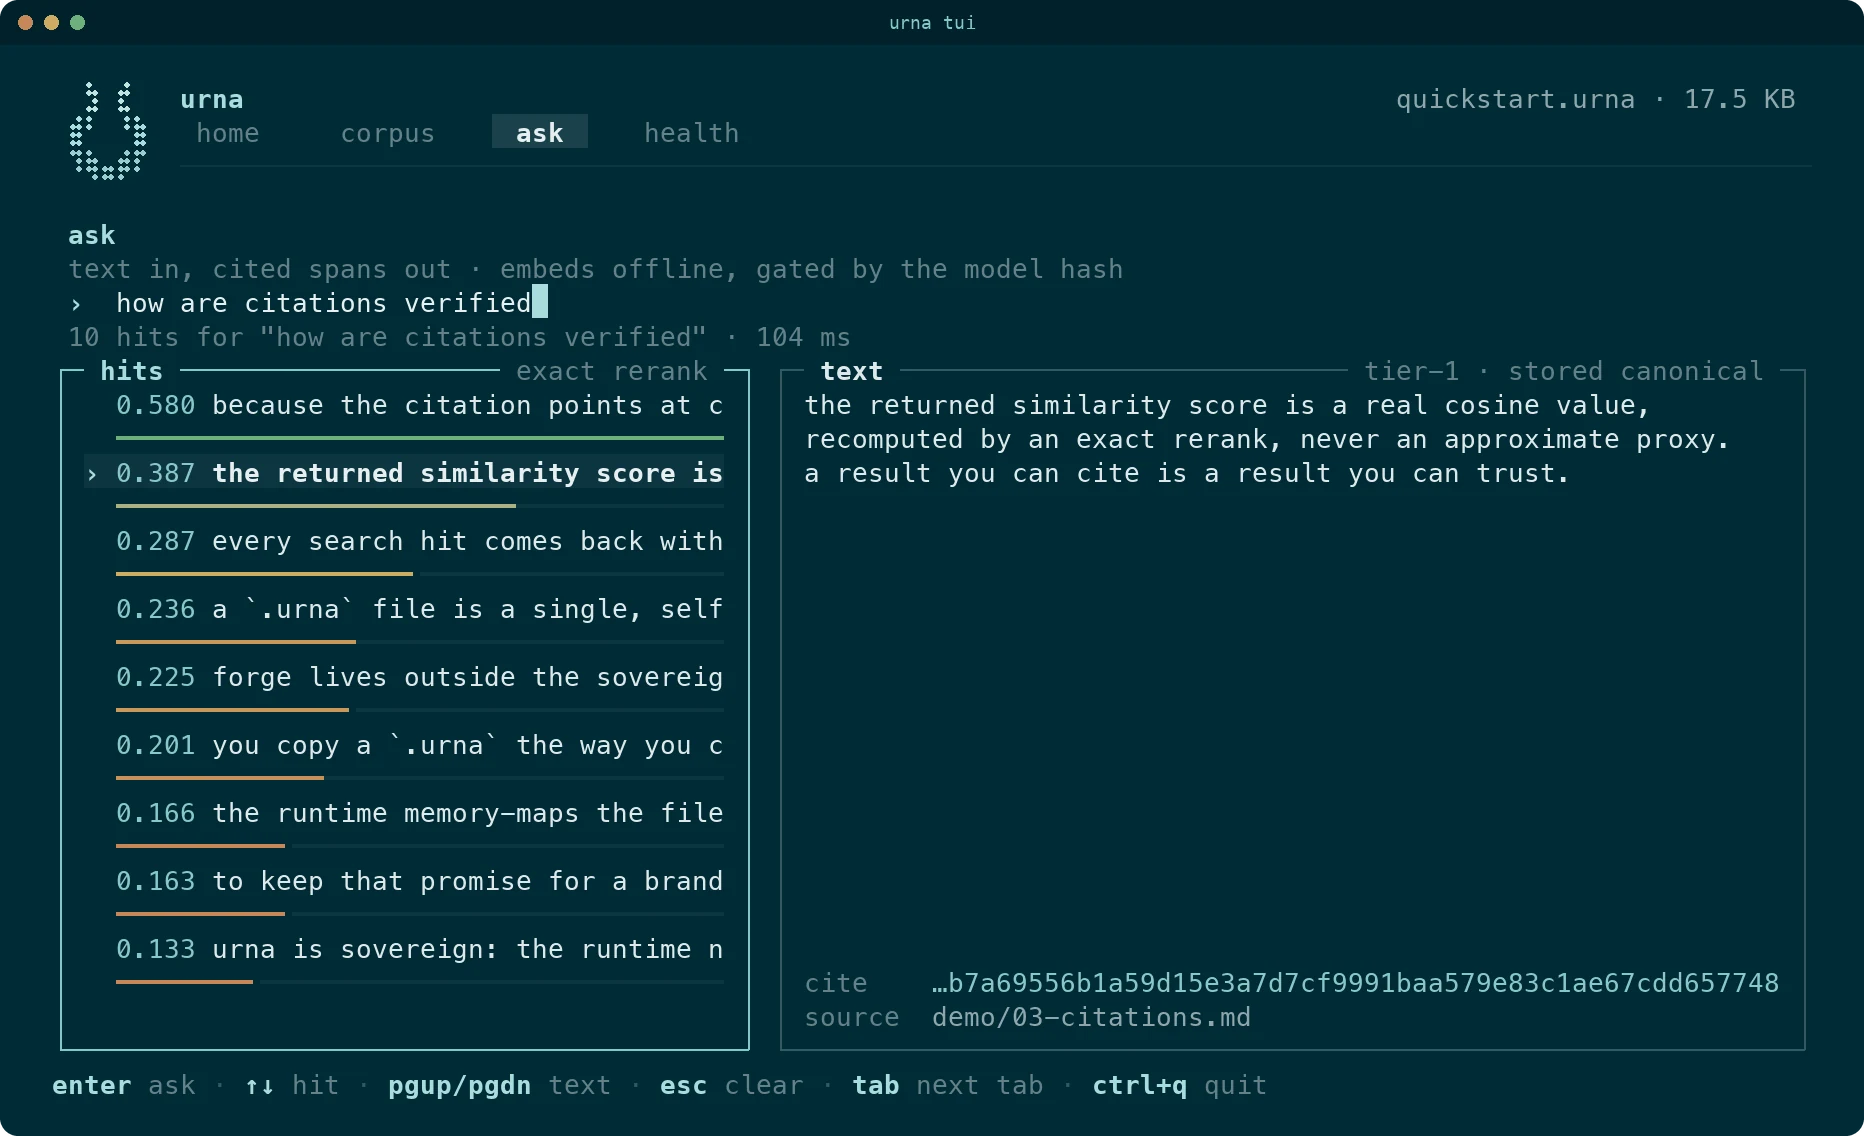
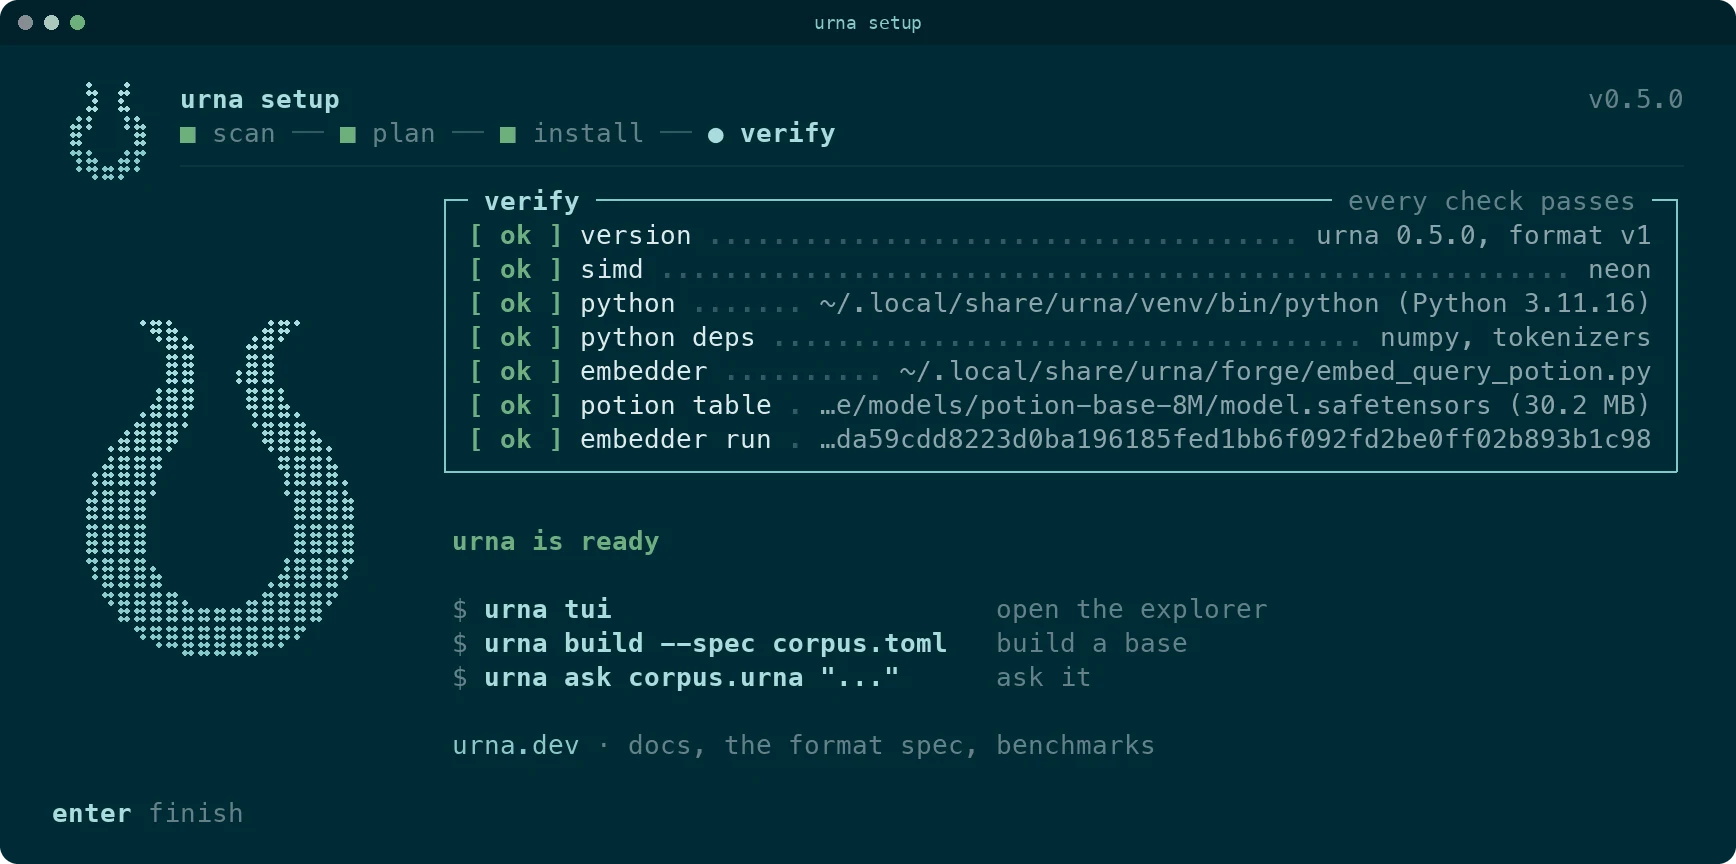
urna tui öffnet eine .urna, stellt ihr Fragen und prüft die Installation, ohne das Terminal zu verlassen. urna setup zeigt den Plan, bevor es etwas schreibt, und endet mit den Checks von doctor
urna tui im Tab ask: zehn zitierte Treffer für eine Frage, der gespeicherte Text des ausgewählten und sein Verweis
urna tui
urna setup im Schritt verify, alle Checks bestanden
urna setup
engine

Eine Datei und ein Vektor rein, Treffer raus. Kein Python.

  • inspect
  • validate
  • stats
  • media
  • search
  • search-ann
  • search-graph
  • search-space
  • search-text
  • benchmark
  • cite
  • doctor
agent

Text oder eine Spec rein, zitierte Antworten raus, über den Offline-Embedder in Python.

  • ask
  • retrieve
  • build
setup

Der Installer, in dem jeder Kanal endet, und der Terminal-Explorer.

  • setup
  • tui
Bevor du loslegst
Was beim ersten Lesen meistens hakt. Der Rest steht in der Doku, mit Befehl und Ausgabe
Zur Doku

Deine Wissensbasis, bereit zum Mitnehmen

Installieren, Korpus bauen, Datei in die App kopieren. Der Rest ist mmap
Installieren
v0.5.1 · MIT · macOS, Linux und Windows