Toda la base de conocimiento en un archivo
 .csv.jsonl.sqlite
 .jpg
 Island
 Forest
 Mountain
Una carpeta y unas pocas líneas de TOML se vuelven un solo .urna: chunks, vectores, índice, medios y manifest, cada sección firmada.
Los escaneos de las cartas entran al archivo en AV1 y los vectores pasan a un preset más chico. El archivo se achica, la cita sigue igual.
El gate de model_hash revisa el modelo, HNSW recorre el grafo, BM25 encuentra la palabra y el coseno exacto define el orden.
La respuesta trae la cita de vuelta hasta la fuente, y urna validate revisa cada capa antes de la primera consulta, sin red.
De una carpeta de documentos
a un archivo que responde



Lo que cabe en un .urna






00100000 01010011 01111001 01110011 01110100 01100101 01101101 00111010 00100000 01000011 01100001 01110010 01100100 01110011


Benchmark público, la misma vara


Benchmark del 2026-09-10 en arm64, un solo hilo. Lo que Urna no hace: update y delete in situ, filtros por metadatos, escrituras concurrentes. Ver la tabla completa.
Los benchmarks de urna
Compresión frente a búsqueda por nombre
7 archivos · 1000 consultas cada unoveces más pequeño que los 3,98 GB de JPEG de origen. El archivo en crf50 pesa 533 MB y encuentra la carta por nombre tantas veces como el lossless de 3,61 GB: txt@1 a +0,001, dentro del error estándar.
Qué mide esta métrica
txt@1 es la fracción de las 1000 consultas en las que la carta correcta salió en primer lugar. La consulta es el nombre de la carta como texto ("artwork of the card {name}"), buscado en el espacio de imagen de clip: el modelo solo ve el arte, por eso el nivel es bajo en todos los archivos; lo que importa es dónde cae.
drift es el coseno entre el vector de la imagen comprimida y el de la original: 1,00 es idéntico, y cuanto más bajo, más cambió el codec lo que ve el modelo. El peor decil (p10) es la carta en el borde del 10 % que más cambió; la mediana (p50) es la carta del medio.
Cómo leer este gráfico
Cada columna es un archivo con las mismas 38.627 cartas, del lossless (3,61 GB) al AV1 en crf60 (230 MB), en orden de compresión.
Arriba, las dos líneas de drift bajan todo el tiempo y cruzan el floor del gate ya en el segundo archivo. Abajo, la búsqueda se mantiene plana hasta crf50: las barras verdes están dentro de un error estándar del lossless; la línea discontinua marca dónde cae la búsqueda, y las barras rojas son los archivos que quedan más allá.
| archivo | tamaño | drift p10 | txt@1 | ±1 error estándar | z vs lossless |
|---|---|---|---|---|---|
| lossless | 3,61 GB | 0,9968 | 0,092 | 0,0091 | 0,00 |
| neardup | 1,37 GB | 0,9666 | 0,096 | 0,0093 | 0,31 |
| avif q48 | 1,2 GB | 0,9680 | 0,096 | 0,0093 | 0,31 |
| crf40 | 981 MB | 0,9594 | 0,089 | 0,0090 | -0,23 |
| crf50 | 533 MB | 0,9389 | 0,093 | 0,0092 | 0,08 |
| crf55 | 370 MB | 0,9211 | 0,074 | 0,0083 | -1,46 |
| crf60 | 230 MB | 0,8866 | 0,069 | 0,0080 | -1,89 |
1000 consultas por archivo, las mismas cartas en todos; error estándar binomial; z es la distancia del txt@1 de cada archivo al del lossless en errores estándar combinados: hasta crf50, ninguno pasa de 1.
medido el 2026-09-12 · benchmark/experiments/14-utility-ladder/results.json


curl -sSf https://raw.githubusercontent.com/hoffresearch/urna/main/scripts/install.sh | sh
urna setupurna build --spec corpus.tomlurna ask corpus.urna "¿funciona sin conexión?" -k 3urna retrieve corpus.urna "¿funciona sin conexión?" -k 5 --format jsonlimport urna
from urna.embed_potion import potion_embedder
emb, db = potion_embedder(), urna.open("corpus.urna")
qvec = emb.embed_texts(["¿funciona sin conexión?"])[0]
hits = db.retrieve(qvec, 5, expected_model_hash=emb.model_hash())urna validate corpus.urnaurna cite corpus.urna "urna://content_hash/chunk_id"urna benchmark corpus.urna -q 100 -k 10 --ann 100Una release, todos los gestores de paquetes


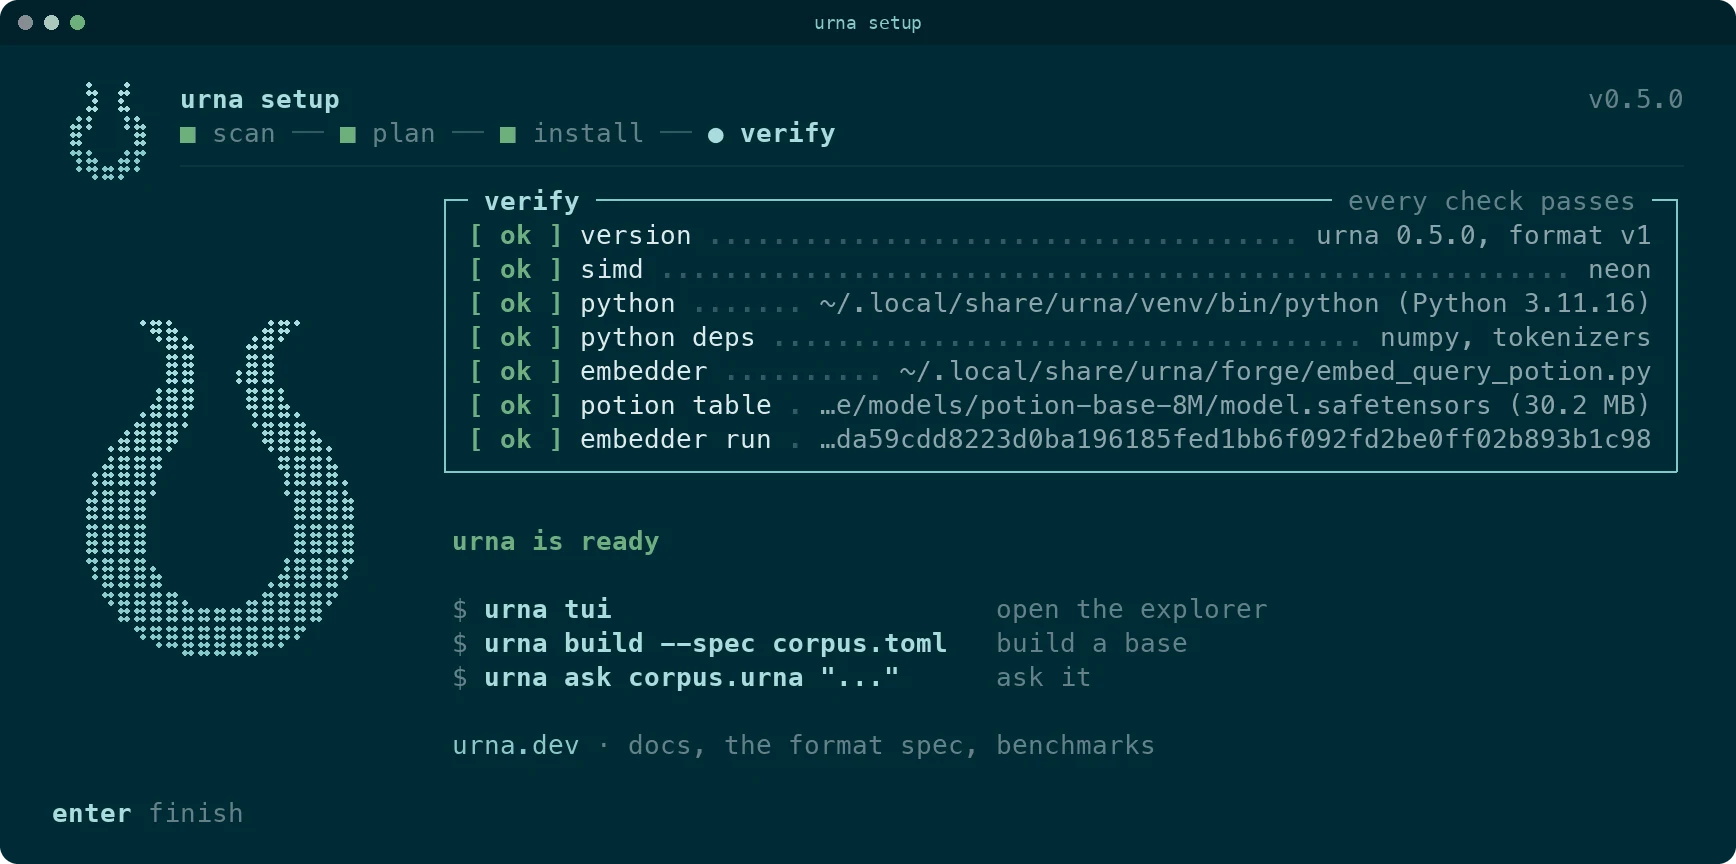
npx @urna/cli validate corpus.urnauvx --from urna urna validate corpus.urnacargo binstall urnaTres grupos de verbos y una pantalla para usarlos
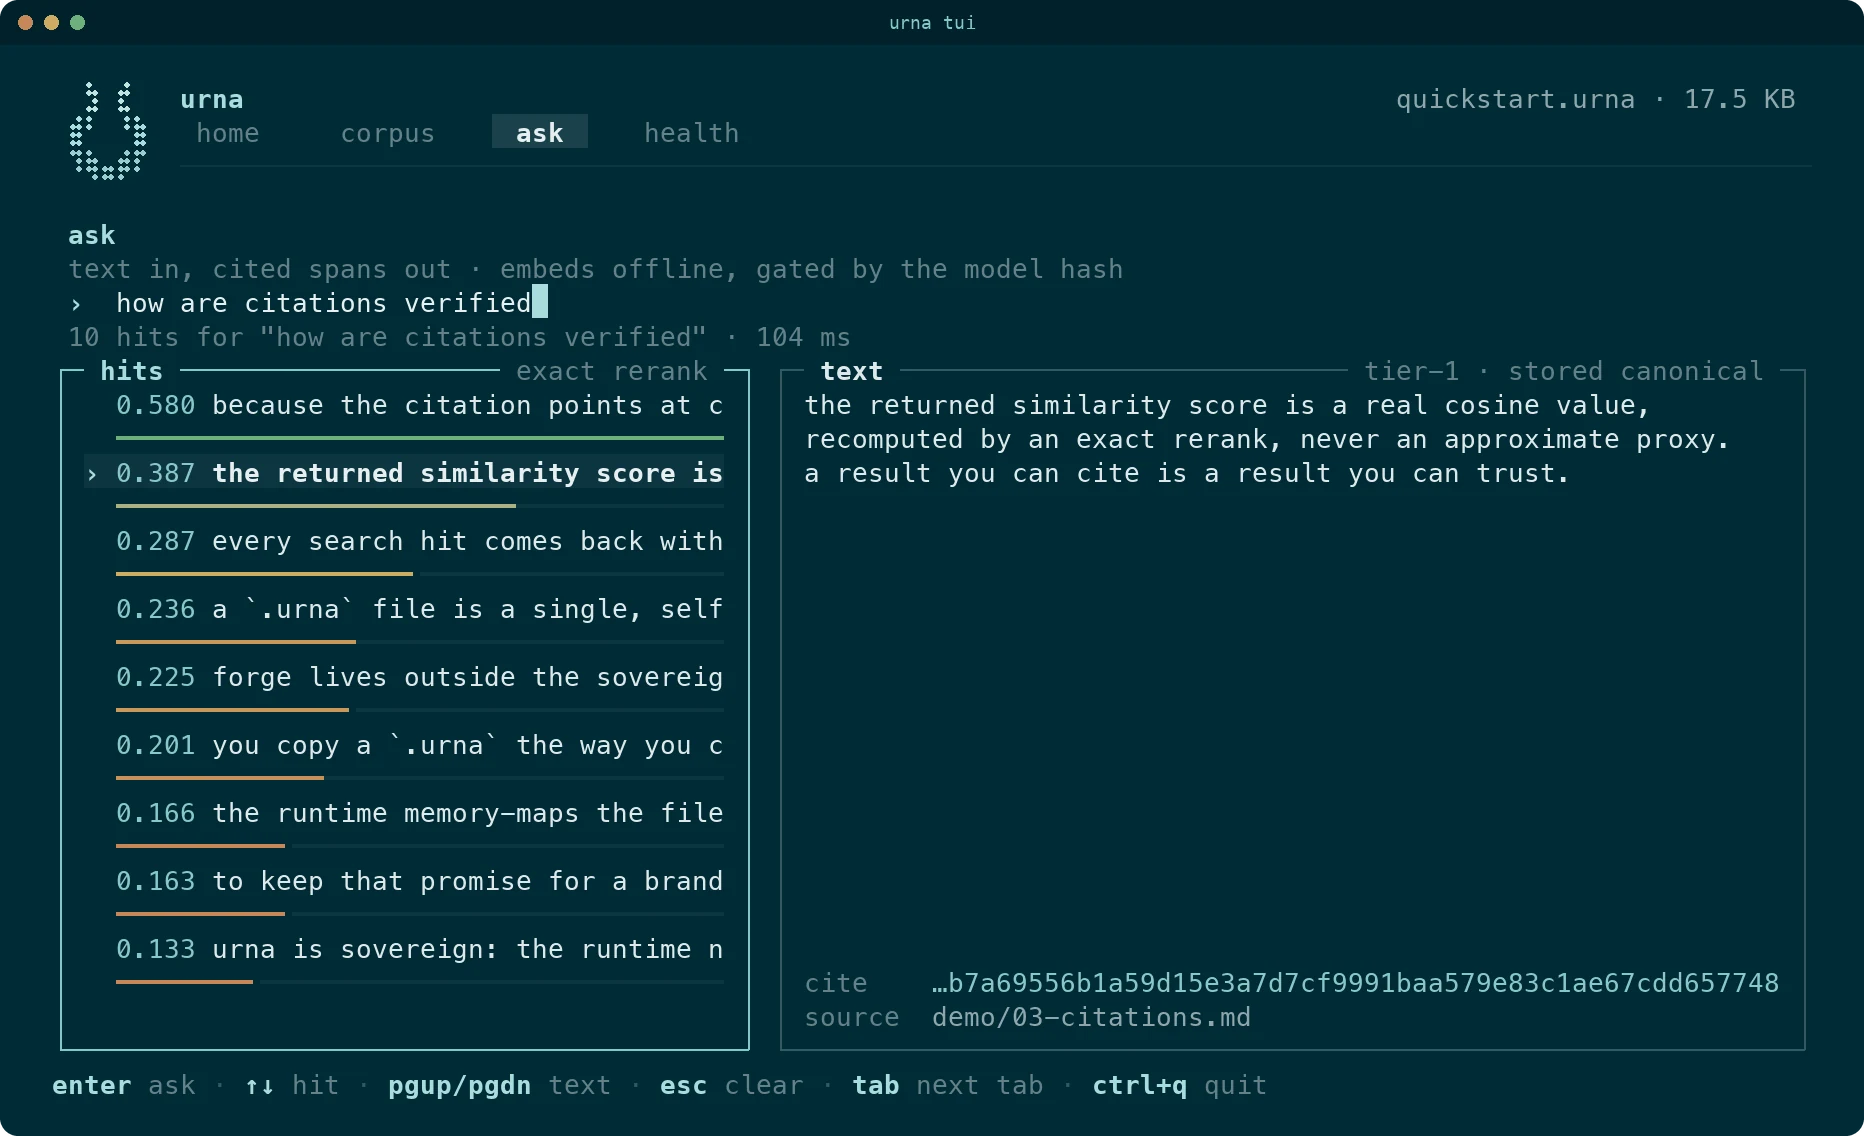
Entra un archivo y un vector, salen resultados. Sin Python.
- inspect
- validate
- stats
- media
- search
- search-ann
- search-graph
- search-space
- search-text
- benchmark
- cite
- doctor
Entra texto o un spec, salen respuestas citadas, con el embedder offline de Python.
- ask
- retrieve
- build
El instalador en el que termina todo canal, y el explorador de la terminal.
- setup
- tui