Toda a base de conhecimento em um arquivo

O Urna guarda textos, imagens e referências já convertidos em vetores dentro de um único .urna. Seu app copia esse arquivo e responde perguntas citando a fonte, sem servidor, sem internet e sem chave de API.
v0.5.1 · código aberto sob MIT · Rust + Python
.csv
.jsonl
.sqlite
.jpg
Island
Basic Land · Island
corpus/
01001001 01110011 01101100 01100001 01101110 01100100IslandBasic Land · Island256 números por chunk, do potion
corpus.toml
[source] kind = "sqlite"
[[models]] preset = "potion"
[[models]] preset = "clip-vit-b32"
Island
JPEGAV1
Basic Land · Island
JPEGAV1
103 kB → 13 kBmédia por cartaJPEG, fonte · AV1, no arquivo
drift p50 0,961
scans das cartas4 GB
.urna533 MB
menor
100% do exact61% do exact34% do exact26% do exact21% do exact
model_hashclip-vit-b32
HNSW + BM25 → cosine
Island
Forest
Mountain
p50, texto pra imagem
Island
Basic Land · Island
urna validateheaderseçõesarquivoconteúdo
O runtime nunca abre um socket

Uma pasta e poucas linhas de TOML viram um .urna só: chunks, vetores, índice, mídia e manifest, cada seção assinada.

Os scans das cartas entram no arquivo em AV1 e os vetores passam pra um preset menor. O arquivo encolhe, a citação continua a mesma.

O gate do model_hash confere o modelo, o HNSW anda pelo grafo, o BM25 acha a palavra e o cosseno exato define a ordem.

A resposta traz a citação de volta até a fonte, e o urna validate confere cada camada antes da primeira consulta, offline.

como funciona

Da pasta de documentos
ao arquivo que responde

1
Junte as fontes
Textos, PDFs, planilhas, imagens. Você descreve de onde vem cada coisa e qual modelo vai ler, em um TOML de poucas linhas.
2
Gere o .urna
Uma chamada faz o resto: urna.build no Python, ou urna build --spec num checkout do repo. Ela corta em trechos, calcula os vetores, monta os índices e assina cada seção com SHA-256. O resultado é um arquivo só, igual byte a byte em qualquer máquina.
3
Pergunte de dentro do app
O runtime em Rust abre o arquivo por mmap e devolve os trechos mais próximos, cada um com uma citação urna:// que leva de volta ao texto original.
Aberto pra auditar, como todo banco de dados deveria ser
Autocontido, verificável, reproduzível, offline.
O arquivo é o banco inteiro
Trechos, vetores, índices, mídia e manifesto no mesmo .urna. Copia como copiaria um SQLite, versiona no git, embarca no instalador. Não existe serviço pra subir nem índice pra sincronizar.
Cada resposta aponta pra um trecho que você pode conferir
Toda seção tem SHA-256, o arquivo inteiro tem, e o conteúdo decodificado tem. A citação urna://content_hash/chunk_id continua a mesma depois de comprimir o texto, e urna cite resolve ela pro trecho guardado.
Offline, sem exceção
O runtime nunca abre socket. O modelo de texto padrão vem no pacote Python, ou o urna setup baixa uma vez na instalação. Se o modelo da pergunta não bate com o do arquivo, a busca para na hora em vez de devolver lixo com cara de resposta.
na prática

Benchmark público, mesma régua

urna contra usearch, hnswlib, sqlite-vec e lancedb, na mesma máquina, com os dados e o comando pra reproduzir
0,72 ms
p50
1,02 ms
p99
recall 1,0
0,72 ms por consulta, recall 1,0
100 mil vetores de 384 dimensões, 200 consultas, uma thread. O preset hybrid respondeu com p50 de 0,72 ms e p99 de 1,02 ms. É o único da tabela que confere os próprios bytes antes da primeira consulta; isso custa uns 360 ms na abertura.
Ver na documentação: 0,72 ms por consulta, recall 1,0
38 mil cartas de Magic em 533 MB
4 GB de scans em JPEG viraram um arquivo 7,46 vezes menor, com texto, vetores, índice e as imagens em AV1 dentro, e a busca acha a carta tanto quanto no lossless.
Ver na documentação: 38 mil cartas de Magic em 533 MB
30.725
trechos
7
datasets
FakeRecogna11,9 mil
Fake.br7,2 mil
FakeTrue.Br3,6 mil
factck-br1,3 mil
30 mil trechos de checagem de fatos
O truw pontua afirmações em português contra sete datasets públicos de fake news. O corpus é um .urna de 30.725 trechos: 120 MB no preset exact, 31 MB no tiny.
Ver na documentação: 30 mil trechos de checagem de fatos

Benchmark de 2026-09-10 em arm64, single thread. O que o Urna não faz: update e delete no lugar, filtro por metadado, escrita concorrente. Ver a tabela completa.

benchmarks

Benchmarks do urna

Mede compressão, busca e latência nas 38.627 cartas de Magic (3,98 GB de JPEG) guardadas num arquivo .urna, e o urna contra usearch, hnswlib, sqlite-vec e lancedb nos mesmos vetores e na mesma máquina

Compressão contra busca pelo nome

7 arquivos · 1.000 consultas cada
índice de compressão sem perda de busca7,46x

vezes menor que os 3,98 GB de JPEG de origem. O arquivo em crf50 tem 533 MB e acha a carta pelo nome tanto quanto o lossless de 3,61 GB: txt@1 a +0,001, dentro do erro padrão.

lossless · 3,61 GB
neardup · 1,37 GB
crf50 · 533 MB

O que esta métrica mede

txt@1 é a fração das 1.000 consultas em que a carta certa veio em primeiro lugar. A consulta é o nome da carta em texto ("artwork of the card {nome}"), buscado no espaço de imagem do clip: o modelo só vê a arte, por isso o nível é baixo em todos os arquivos; o que importa é onde ele cai.

drift é o cosseno entre o vetor da imagem comprimida e o da original: 1,00 é igual, e quanto menor, mais o codec mexeu no que o modelo enxerga. O pior decil (p10) é a carta na borda das 10% que mais mudaram; a mediana (p50) é a carta do meio.

Como ler este gráfico

Cada coluna é um arquivo com as mesmas 38.627 cartas, do lossless (3,61 GB) ao AV1 em crf60 (230 MB), em ordem de compressão.

Em cima, as duas linhas de drift descem o tempo todo e cruzam o floor do gate logo no segundo arquivo. Embaixo, a busca fica plana até o crf50: as barras verdes estão dentro de um erro padrão do lossless; a linha tracejada marca onde a busca cai, e as vermelhas são os arquivos além dela.

arquivotamanhodrift p10txt@1±1 erro padrãoz vs lossless
lossless3,61 GB0,99680,0920,00910,00
neardup1,37 GB0,96660,0960,00930,31
avif q481,2 GB0,96800,0960,00930,31
crf40981 MB0,95940,0890,0090-0,23
crf50533 MB0,93890,0930,00920,08
crf55370 MB0,92110,0740,0083-1,46
crf60230 MB0,88660,0690,0080-1,89

1.000 consultas por arquivo, as mesmas cartas em todos; erro padrão binomial; z é a distância do txt@1 de cada arquivo ao do lossless em erros padrão combinados: até crf50 nenhum passa de 1.

medido em 2026-09-12 · benchmark/experiments/14-utility-ladder/results.json

presets
Escolha o tamanho. O conteúdo é o mesmo
Cinco presets combinam compressão do texto, precisão dos vetores e índices, mais o micro, que corta dimensões. Três aqui, todos na documentação
Pra pergunta com sigla, nome próprio, termo raro:
Texto comprimido com zstd
Vetores em float32
HNSW + BM25 como candidatos
Rerank por cosseno exato
Ver o preset
Medido em 30.725 trechos. O recall aqui mede estabilidade do ranking sob quantização, não acerto em perguntas reais. Ver os cinco presets e o micro.
integração
Instala em um comando. Integra em cinco linhas
Um binário em Rust com três grupos de verbos (engine, agent, setup) e uma API Python. Depois da instalação, tudo abaixo roda sem rede
$
Instale
instalador
$
Monte
urna build
$
Pergunte
urna ask
O instalador confere o SHA-256 antes de gravar. urna setup baixa o embedder offline uma vez e termina no urna doctor, que diz qual camada falhou, se alguma.
curl -sSf https://raw.githubusercontent.com/hoffresearch/urna/main/scripts/install.sh | sh urna setup
Fontes, mídia e modelo em um TOML, rodando num checkout do repo. O mesmo spec gera a mesma base em qualquer máquina.
urna build --spec corpus.toml
Trechos citados, direto no terminal.
urna ask corpus.urna "funciona sem internet?" -k 3
JSONL com trecho, fonte, score e citação, pronto pro seu app ou agente.
urna retrieve corpus.urna "funciona sem internet?" -k 5 --format jsonl
Abre por mmap, devolve hits citados. O model_hash esperado barra modelo errado antes da busca.
import urna from urna.embed_potion import potion_embedder emb, db = potion_embedder(), urna.open("corpus.urna") qvec = emb.embed_texts(["funciona sem internet?"])[0] hits = db.retrieve(qvec, 5, expected_model_hash=emb.model_hash())
Todos os checksums antes de distribuir: cabeçalho, seções, arquivo, conteúdo.
urna validate corpus.urna
Da citação de volta pro texto guardado, com os hashes que provam.
urna cite corpus.urna "urna://content_hash/chunk_id"
Latência e recall na sua máquina, no seu corpus.
urna benchmark corpus.urna -q 100 -k 10 --ann 100
canais

Uma release, todo gerenciador de pacote

O mesmo urna 0.5.1 no crates.io, no PyPI, no npm e no Homebrew, com checksum e attestation do lado de cada arquivo
O mesmo binário em todo lugar
cargo, pip, npm, bun, pnpm, yarn, brew, o one-liner do curl e o PowerShell instalam o mesmo build: macOS e Linux em arm64 e x86_64, Windows em x86_64. npx e uvx rodam sem instalar nada.
Ver na documentação: O mesmo binário em todo lugar
tar.xz
zip
sha256
sigstore
SBOM
ssh tag
Uma release que dá pra conferir
Cada arquivo vem com o seu .sha256 e uma attestation do sigstore que o gh attestation verify confere, mais um SBOM CycloneDX e binários feitos com cargo-auditable. As tags de release são assinadas por ssh.
Ver na documentação: Uma release que dá pra conferir
Dentro do seu app, sem a CLI
urna-format e urna-runtime estão no crates.io pra Rust, e o pacote Python abre o mesmo arquivo. O repo tem exemplos de fastapi, flask e jupyter e um Dockerfile, e cargo install urna --no-default-features deixa uma CLI só de engine com 2,1 MB.
Ver na documentação: Dentro do seu app, sem a CLI
Sem instalarnpx @urna/cli validate corpus.urnauvx --from urna urna validate corpus.urnacargo binstall urna
no terminal

Três grupos de verbos e uma tela pra usar eles
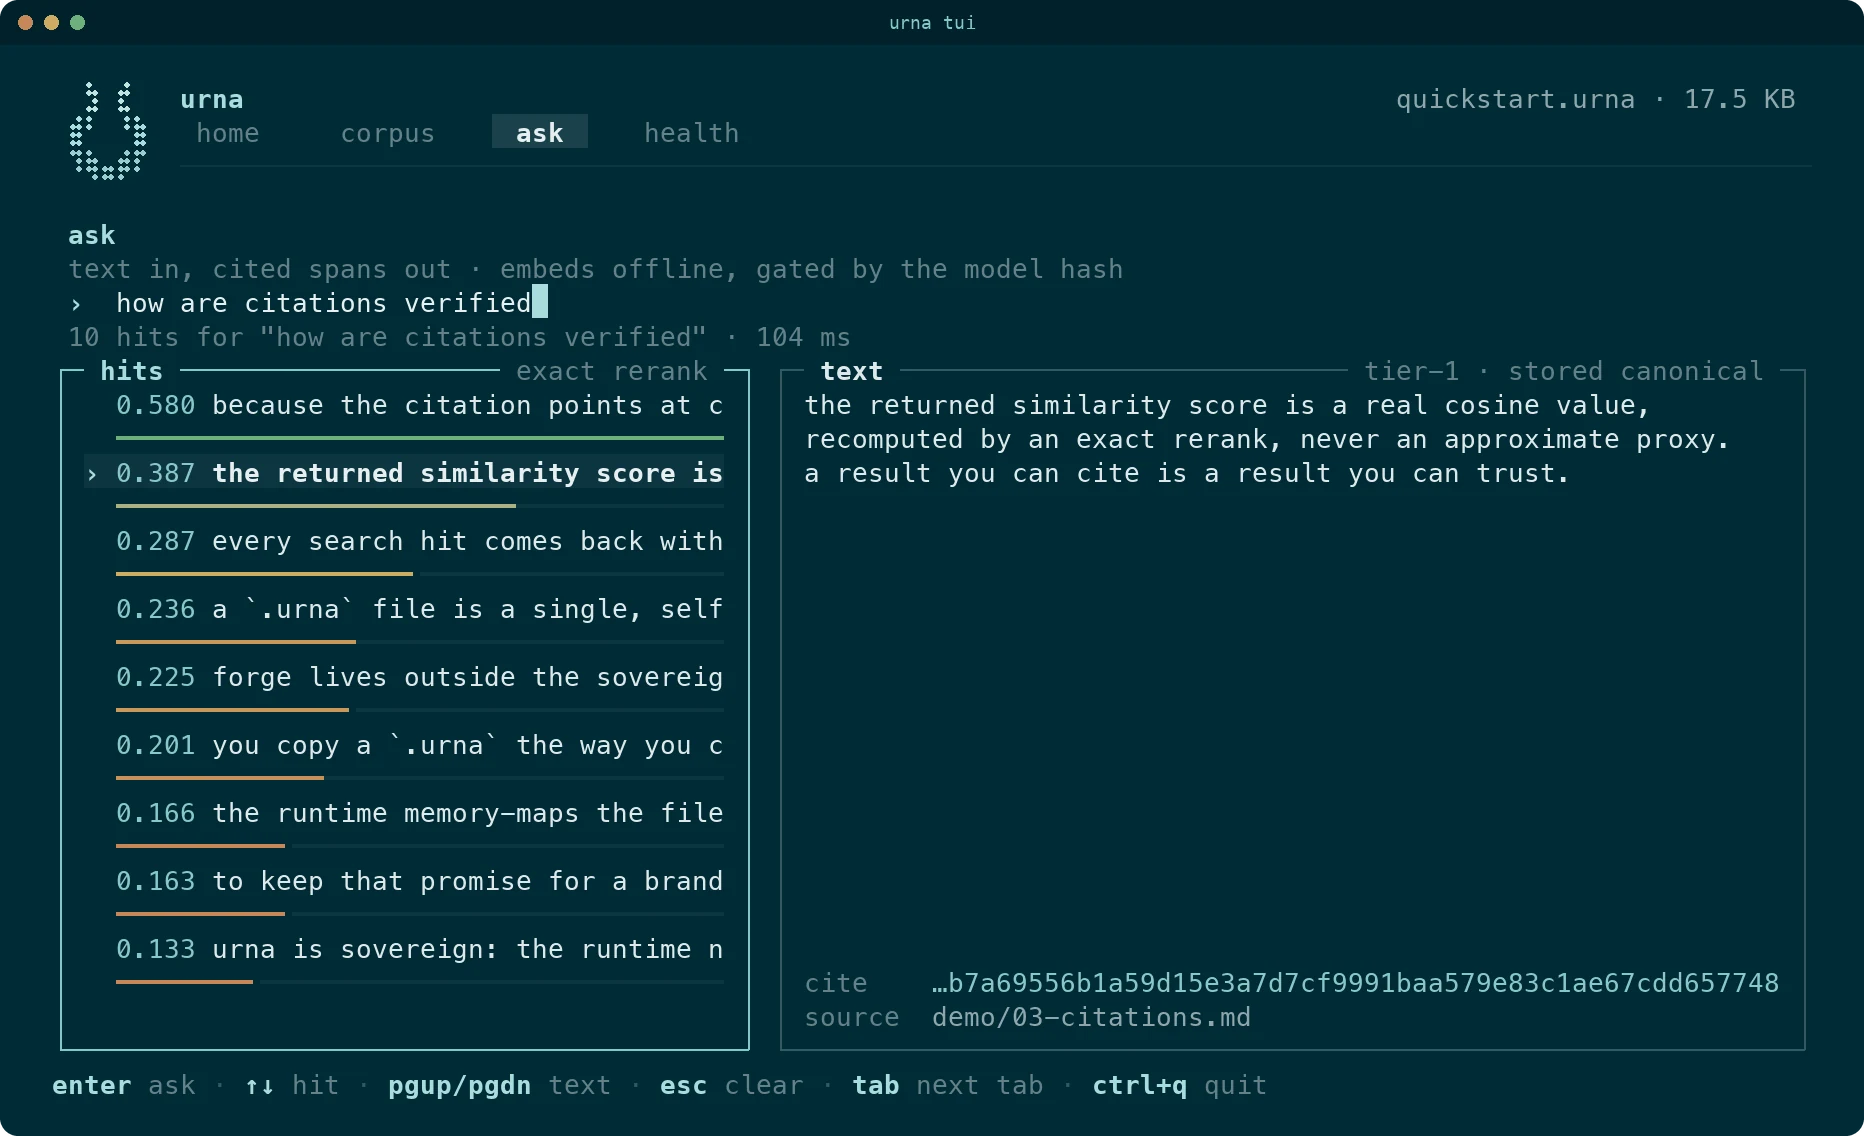
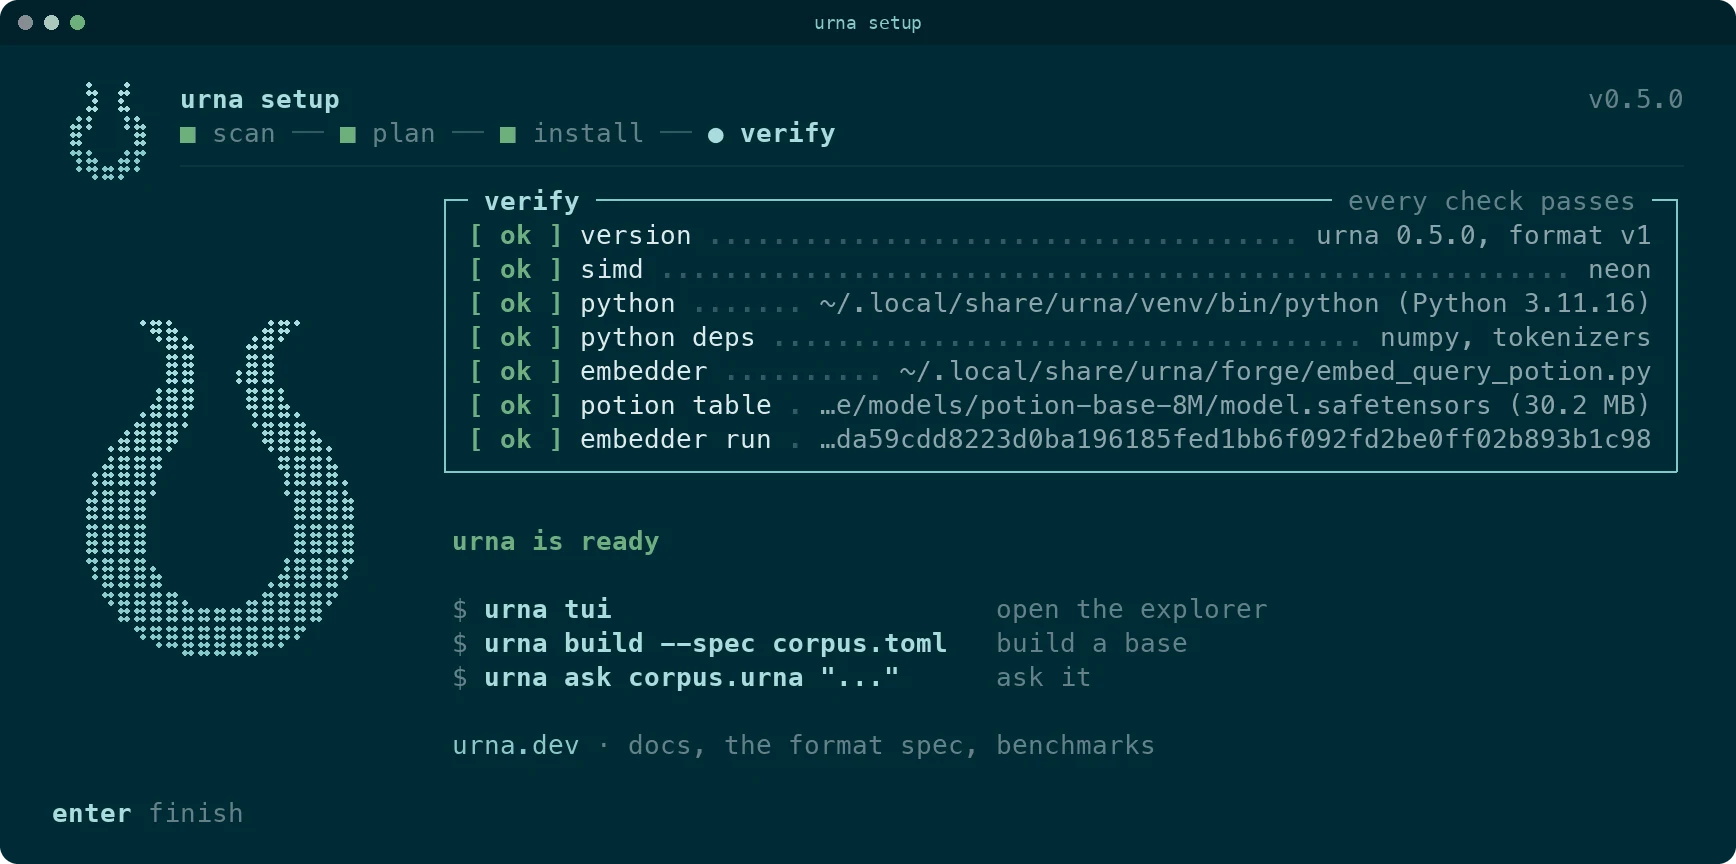
urna tui abre um .urna, faz perguntas pra ele e confere a instalação sem sair do terminal. urna setup mostra o plano antes de gravar qualquer coisa e termina nos checks do doctor
urna tui na aba ask: dez hits citados pra uma pergunta, o texto guardado do selecionado e a citação dele
urna tui
urna setup no passo verify, com todos os checks passando
urna setup
engine

Um arquivo e um vetor entram, hits saem. Sem Python.

  • inspect
  • validate
  • stats
  • media
  • search
  • search-ann
  • search-graph
  • search-space
  • search-text
  • benchmark
  • cite
  • doctor
agent

Texto ou um spec entram, respostas citadas saem, pelo embedder Python offline.

  • ask
  • retrieve
  • build
setup

O instalador em que todo canal termina, e o explorador do terminal.

  • setup
  • tui
Antes de começar
O que costuma travar na primeira leitura. O resto está na documentação, com comando e saída
Ver a documentação

Sua base de conhecimento, pronta pra viajar

Instale, monte o corpus, copie o arquivo pro app. O resto é mmap
Instalar
v0.5.1 · MIT · macOS, Linux e Windows