पूरा knowledge base, एक फ़ाइल में

Urna टेक्स्ट, इमेज और रेफ़रेंस को वेक्टर में बदलकर एक ही .urna के अंदर रखता है। आपका ऐप यह फ़ाइल कॉपी करता है और स्रोत का हवाला देते हुए सवालों के जवाब देता है, बिना सर्वर, बिना इंटरनेट और बिना API key के।
v0.5.1 · MIT के तहत open source · Rust + Python
.csv
.jsonl
.sqlite
.jpg
Island
Basic Land · Island
corpus/
01001001 01110011 01101100 01100001 01101110 01100100IslandBasic Land · Islandहर chunk में 256 संख्याएँ, potion से
corpus.toml
[source] kind = "sqlite"
[[models]] preset = "potion"
[[models]] preset = "clip-vit-b32"
Island
JPEGAV1
Basic Land · Island
JPEGAV1
103 kB → 13 kBप्रति कार्ड औसतJPEG, स्रोत · AV1, फ़ाइल में
drift p50 0.961
कार्ड स्कैन4 GB
.urna533 MB
छोटी
100% exact का61% exact का34% exact का26% exact का21% exact का
model_hashclip-vit-b32
HNSW + BM25 → cosine
Island
Forest
Mountain
p50, टेक्स्ट से इमेज
Island
Basic Land · Island
urna validateheaderसेक्शनफ़ाइलसामग्री
runtime कभी socket नहीं खोलता

एक फ़ोल्डर और TOML की कुछ पंक्तियाँ एक .urna बन जाती हैं: chunks, वेक्टर, इंडेक्स, मीडिया और manifest, हर सेक्शन हस्ताक्षरित।

कार्डों के स्कैन AV1 में फ़ाइल के अंदर जाते हैं और वेक्टर छोटे preset पर चले जाते हैं। फ़ाइल छोटी होती है, उद्धरण वही रहता है।

model_hash गेट मॉडल जाँचता है, HNSW ग्राफ़ पर चलता है, BM25 शब्द मिलाता है और सटीक cosine क्रम तय करता है।

जवाब स्रोत तक ले जाने वाला उद्धरण साथ लाता है, और urna validate पहली क्वेरी से पहले हर परत ऑफ़लाइन जाँचता है।

यह कैसे काम करता है

दस्तावेज़ों के फ़ोल्डर से
जवाब देने वाली फ़ाइल तक

1
स्रोत इकट्ठा करें
टेक्स्ट, PDF, स्प्रेडशीट, इमेज। हर चीज़ कहाँ से आती है और कौन-सा मॉडल उसे पढ़ेगा, यह आप कुछ लाइनों की एक TOML फ़ाइल में लिख देते हैं।
2
.urna बनाएँ
बाक़ी सब एक call से हो जाता है: Python में urna.build, या repo के checkout से urna build --spec। टेक्स्ट chunks में बँटता है, वेक्टर निकलते हैं, इंडेक्स बनते हैं और हर सेक्शन पर SHA-256 से साइन होता है। नतीजा एक ही फ़ाइल है, जो किसी भी मशीन पर byte-दर-byte एक जैसी बनती है।
3
ऐप के अंदर से पूछें
Rust runtime फ़ाइल को mmap से खोलता है और सबसे क़रीबी chunks लौटाता है, हर एक के साथ एक urna:// citation, जो आपको वापस मूल टेक्स्ट तक ले जाता है।
ऑडिट के लिए खुला, जैसा हर डेटाबेस को होना चाहिए
अपने-आप में पूरा, जाँचने लायक़, हूबहू दोबारा बनने लायक़, offline।
फ़ाइल ही पूरा डेटाबेस है
chunks, वेक्टर, इंडेक्स, मीडिया और manifest, सब एक ही .urna में। इसे वैसे ही कॉपी करें जैसे SQLite फ़ाइल करते हैं, git में version करें, installer के अंदर ship करें। न कोई सर्विस चलानी है, न कोई इंडेक्स sync में रखना है।
हर जवाब ऐसे chunk की ओर इशारा करता है जिसे आप जाँच सकते हैं
हर सेक्शन का SHA-256 है, पूरी फ़ाइल का भी, और decode किए गए कंटेंट का भी। टेक्स्ट compress होने के बाद भी citation urna://content_hash/chunk_id वही रहता है, और urna cite उसे सहेजे गए chunk तक resolve कर देता है।
Offline, बिना किसी अपवाद के
runtime कभी socket नहीं खोलता। default टेक्स्ट मॉडल Python package के साथ आता है, बाक़ी तरीक़ों में urna setup इसे install के समय एक बार डाउनलोड कर लेता है। अगर query का मॉडल फ़ाइल के मॉडल से मेल नहीं खाता, तो सर्च उसी पल रुक जाती है, बजाय इसके कि जवाब के भेस में कचरा लौटाए।
प्रैक्टिस में

पब्लिक बेंचमार्क, सबके लिए एक ही पैमाना

urna बनाम usearch, hnswlib, sqlite-vec और lancedb, एक ही मशीन पर, डेटा और दोबारा चलाने की कमांड समेत
0.72 ms
p50
1.02 ms
p99
recall 1.0
प्रति query 0.72 ms, recall 1.0
384 dimensions के 1,00,000 वेक्टर, 200 queries, एक थ्रेड। hybrid preset ने 0.72 ms के p50 और 1.02 ms के p99 पर जवाब दिया। टेबल में सिर्फ़ यही है जो पहली query से पहले अपने ही bytes जाँचता है; इसकी क़ीमत खोलते समय क़रीब 360 ms है।
docs में देखें: प्रति query 0.72 ms, recall 1.0
533 MB में 38 हज़ार Magic कार्ड
4 GB के JPEG scans 7.46 गुना छोटी फ़ाइल बन गए, जिसके अंदर टेक्स्ट, वेक्टर, इंडेक्स और AV1 इमेज हैं, और सर्च कार्ड को उतनी ही बार ढूँढती है जितनी lossless फ़ाइल पर।
docs में देखें: 533 MB में 38 हज़ार Magic कार्ड
30,725
chunks
7
datasets
FakeRecogna11.9 हज़ार
Fake.br7.2 हज़ार
FakeTrue.Br3.6 हज़ार
factck-br1.3 हज़ार
fact-checking के 30 हज़ार chunks
truw पुर्तगाली में किए गए दावों को सात public fake news datasets के सामने परखता है। इसका corpus 30,725 chunks का एक .urna है: exact preset में 120 MB, tiny में 31 MB।
docs में देखें: fact-checking के 30 हज़ार chunks

बेंचमार्क 2026-09-10 का, arm64 पर, single thread। Urna क्या नहीं करता: in-place update और delete, metadata filters, concurrent writes। पूरी टेबल देखें।

बेंचमार्क

urna के बेंचमार्क

एक .urna फ़ाइल में रखे 38,627 Magic कार्ड (3.98 GB JPEG) पर कम्प्रेशन, सर्च और latency का माप, और उन्हीं वेक्टर व उसी मशीन पर urna बनाम usearch, hnswlib, sqlite-vec, और lancedb

कम्प्रेशन बनाम नाम से सर्च

7 फ़ाइलें · हर फ़ाइल पर 1,000 queries
सर्च खोए बिना कम्प्रेशन का इंडेक्स7.46x

गुना छोटी, source JPEG के 3.98 GB के मुक़ाबले। crf50 वाली फ़ाइल 533 MB की है और कार्ड को नाम से उतनी ही बार ढूँढती है जितनी 3.61 GB वाली lossless फ़ाइल: txt@1 में फ़र्क +0.001, standard error के अंदर।

lossless · 3.61 GB
neardup · 1.37 GB
crf50 · 533 MB

यह मेट्रिक क्या मापता है

txt@1 उन 1,000 queries का हिस्सा है जिनमें सही कार्ड पहले नंबर पर आया। query कार्ड का नाम है, टेक्स्ट के रूप में ("artwork of the card {name}"), जिसे clip के image space में सर्च किया जाता है: मॉडल सिर्फ़ art देखता है, इसलिए हर फ़ाइल में लेवल कम है; मायने यह रखता है कि वह गिरता कहाँ है।

drift compress की गई इमेज के वेक्टर और मूल इमेज के वेक्टर के बीच का cosine है: 1.00 मतलब एक जैसा, और यह जितना नीचे जाता है, codec ने मॉडल को दिखने वाली चीज़ उतनी ही बदल दी है। सबसे ख़राब decile (p10) उन 10% कार्ड की सीमा पर खड़ा कार्ड है जो सबसे ज़्यादा बदले; मीडियन (p50) बीच वाला कार्ड है।

यह चार्ट कैसे पढ़ें

हर कॉलम एक फ़ाइल है जिसमें वही 38,627 कार्ड हैं, lossless (3.61 GB) से लेकर crf60 पर AV1 (230 MB) तक, कम्प्रेशन के क्रम में।

ऊपर, drift की दोनों लाइनें पूरे रास्ते गिरती हैं और दूसरी फ़ाइल पर ही gate floor को पार कर जाती हैं। नीचे, सर्च crf50 तक सपाट रहती है: हरे bars lossless से एक standard error के अंदर हैं; डैश वाली लाइन बताती है कि सर्च कहाँ गिरती है, और लाल bars उसके बाद की फ़ाइलें हैं।

फ़ाइलसाइज़drift p10txt@1±1 standard errorz बनाम lossless
lossless3.61 GB0.99680.0920.00910.00
neardup1.37 GB0.96660.0960.00930.31
avif q481.2 GB0.96800.0960.00930.31
crf40981 MB0.95940.0890.0090-0.23
crf50533 MB0.93890.0930.00920.08
crf55370 MB0.92110.0740.0083-1.46
crf60230 MB0.88660.0690.0080-1.89

हर फ़ाइल पर 1,000 queries, सब में वही कार्ड; binomial standard error; z हर फ़ाइल के txt@1 की lossless से दूरी है, combined standard errors में: crf50 तक कोई भी 1 से आगे नहीं जाता।

2026-09-12 को मापा गया · benchmark/experiments/14-utility-ladder/results.json

presets
साइज़ चुनें। कंटेंट वही रहता है
पाँच presets टेक्स्ट कम्प्रेशन, वेक्टर precision और इंडेक्स को मिलाते हैं, साथ में micro, जो dimensions काटता है। तीन यहाँ, सभी docs में
acronyms, नामों और कम दिखने वाले शब्दों वाले सवालों के लिए:
zstd से compressed टेक्स्ट
float32 में वेक्टर
candidates के लिए HNSW + BM25
exact cosine से rerank
preset देखें
30,725 chunks पर मापा गया। यहाँ recall यह मापता है कि quantization में ranking कितनी स्थिर रहती है, असली सवालों पर सटीकता नहीं। पाँचों presets और micro देखें।
इंटीग्रेशन
एक कमांड में इंस्टॉल। पाँच लाइनों में इंटीग्रेट
तीन तरह के verbs (engine, agent, setup) वाली एक Rust binary और एक Python API। install के बाद नीचे सब कुछ बिना नेटवर्क के चलता है
$
इंस्टॉल
installer
$
बनाएँ
urna build
$
पूछें
urna ask
installer लिखने से पहले SHA-256 जाँचता है। urna setup offline embedder एक बार डाउनलोड करता है और आख़िर में urna doctor चलाता है, जो बताता है कौन-सी परत fail हुई, अगर कोई हुई।
curl -sSf https://raw.githubusercontent.com/hoffresearch/urna/main/scripts/install.sh | sh urna setup
स्रोत, मीडिया और मॉडल, एक TOML में, repo के checkout से चलता है। वही spec किसी भी मशीन पर वही डेटाबेस बनाता है।
urna build --spec corpus.toml
citation वाले chunks, सीधे terminal में।
urna ask corpus.urna "क्या यह offline चलता है?" -k 3
chunk, स्रोत, score और citation के साथ JSONL, आपके ऐप या agent के लिए तैयार।
urna retrieve corpus.urna "क्या यह offline चलता है?" -k 5 --format jsonl
mmap से खुलता है, citation वाले hits लौटाता है। अपेक्षित model_hash सर्च से पहले ही ग़लत मॉडल को रोक देता है।
import urna from urna.embed_potion import potion_embedder emb, db = potion_embedder(), urna.open("corpus.urna") qvec = emb.embed_texts(["क्या यह offline चलता है?"])[0] hits = db.retrieve(qvec, 5, expected_model_hash=emb.model_hash())
ship करने से पहले हर checksum: हेडर, सेक्शन, फ़ाइल, कंटेंट।
urna validate corpus.urna
citation से वापस सहेजे गए टेक्स्ट तक, उन hashes के साथ जो इसे साबित करते हैं।
urna cite corpus.urna "urna://content_hash/chunk_id"
आपकी मशीन पर, आपके corpus पर latency और recall।
urna benchmark corpus.urna -q 100 -k 10 --ann 100
चैनल

एक release, हर package manager

crates.io, PyPI, npm और Homebrew पर वही urna 0.5.1, हर फ़ाइल के साथ checksum और attestation
हर जगह वही binary
cargo, pip, npm, bun, pnpm, yarn, brew, curl वाली एक लाइन और PowerShell वही build install करते हैं: macOS और Linux पर arm64 और x86_64, Windows पर x86_64। npx और uvx बिना कुछ install किए इसे चला देते हैं।
docs में देखें: हर जगह वही binary
tar.xz
zip
sha256
sigstore
SBOM
ssh tag
ऐसी release जिसे जाँचा जा सके
हर archive के साथ उसका अपना .sha256 और sigstore की एक attestation आती है, जिसे gh attestation verify जाँचता है, साथ में CycloneDX SBOM और cargo-auditable से बनी binaries। release tags ssh से sign होते हैं।
docs में देखें: ऐसी release जिसे जाँचा जा सके
आपकी app के अंदर, CLI के बिना
Rust के लिए urna-format और urna-runtime crates.io पर हैं, और Python package वही फ़ाइल खोलता है। repo में fastapi, flask और jupyter के examples और एक Dockerfile है, और cargo install urna --no-default-features सिर्फ़ engine वाली 2.1 MB की CLI छोड़ता है।
docs में देखें: आपकी app के अंदर, CLI के बिना
बिना install किएnpx @urna/cli validate corpus.urnauvx --from urna urna validate corpus.urnacargo binstall urna
terminal में

verbs के तीन समूह और उन्हें चलाने की एक स्क्रीन
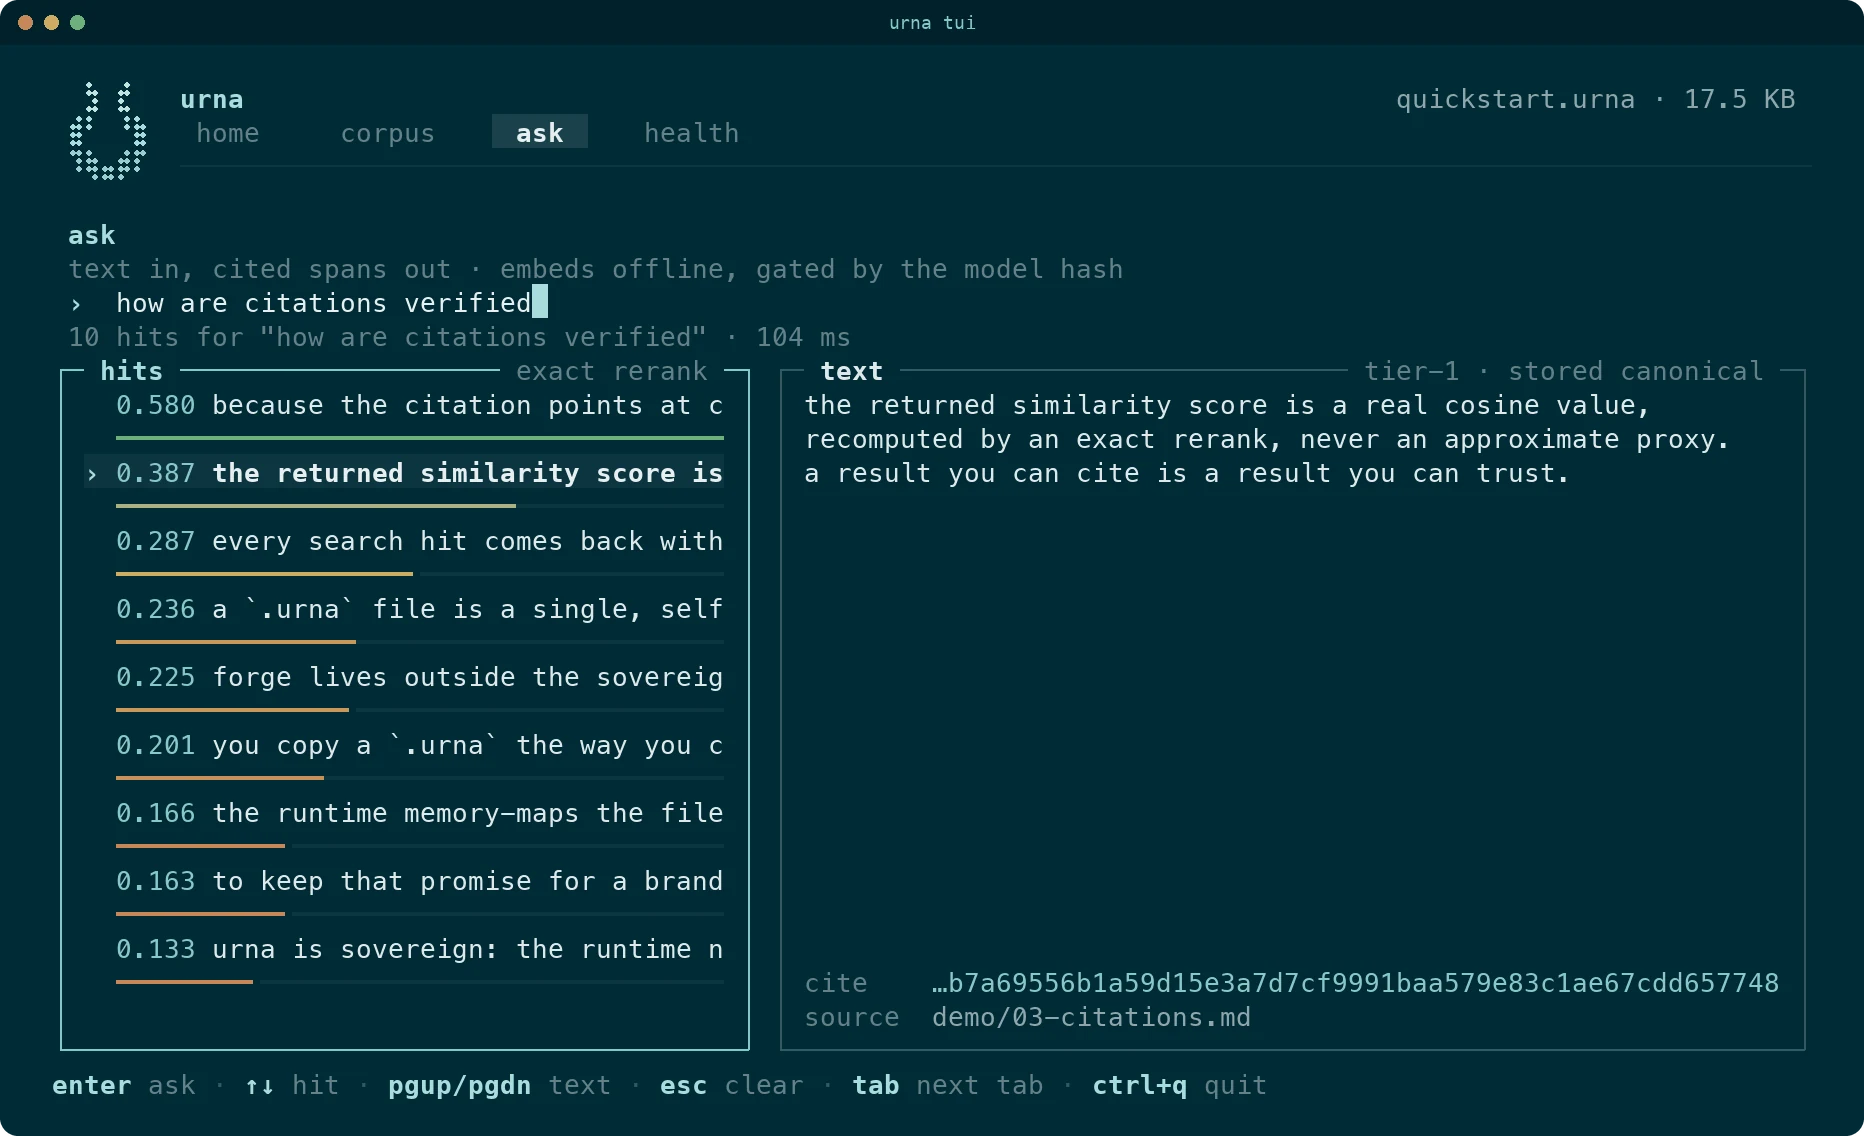
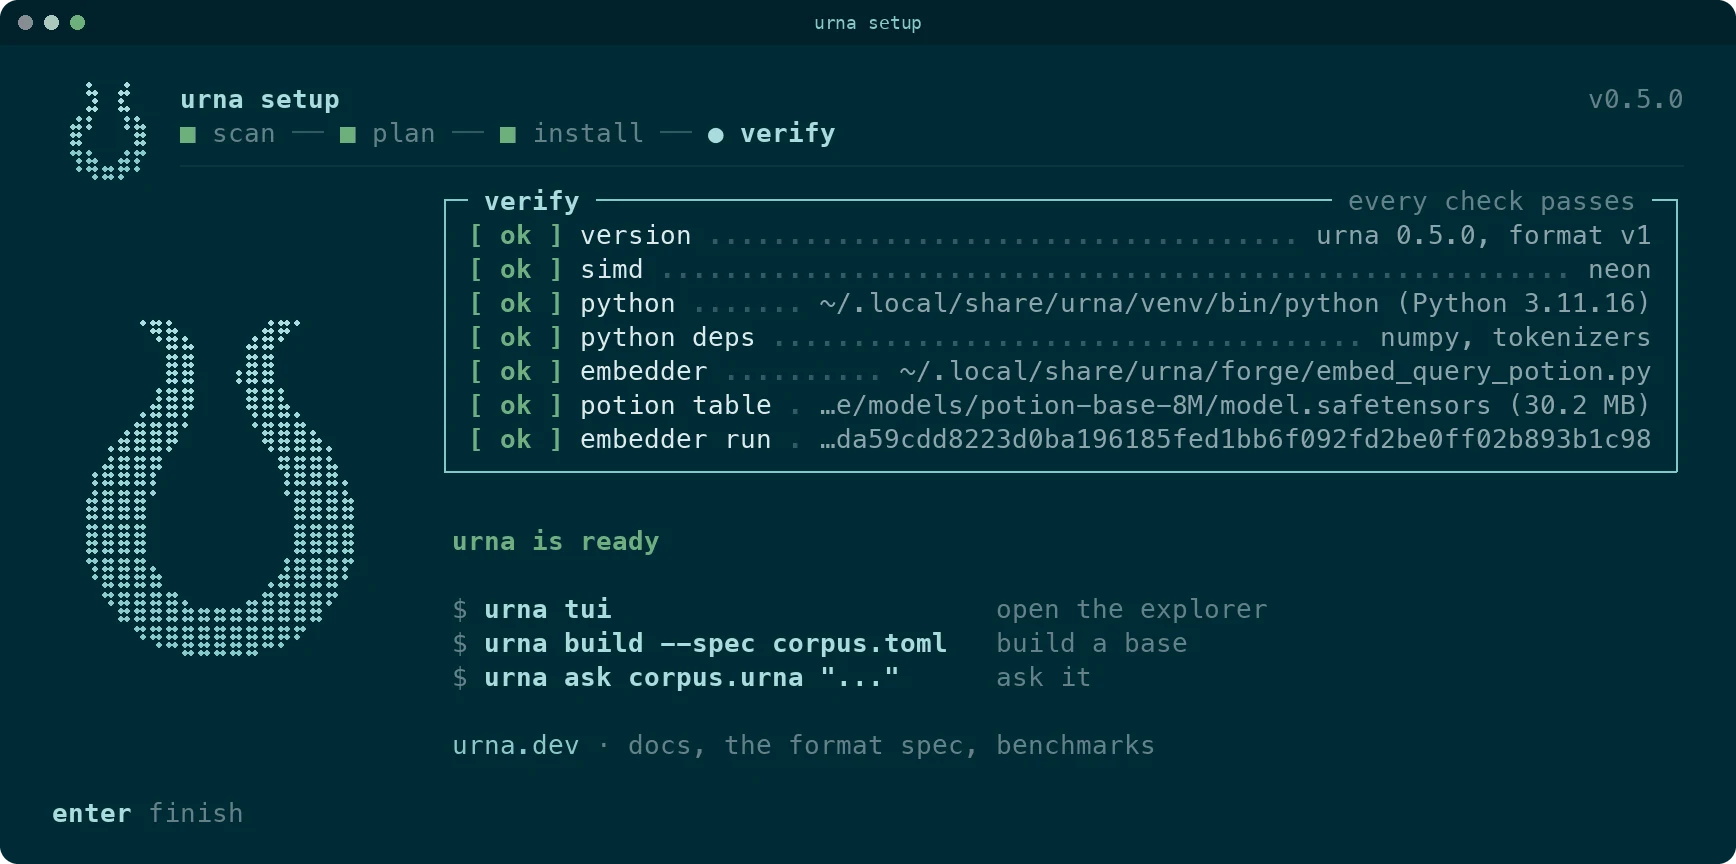
urna tui एक .urna खोलता है, उससे सवाल पूछता है और install जाँचता है, terminal छोड़े बिना। urna setup कुछ भी लिखने से पहले plan दिखाता है और doctor के checks पर ख़त्म होता है
urna tui का ask tab: एक सवाल के दस citation वाले hits, चुने गए hit का सहेजा हुआ टेक्स्ट और उसका citation
urna tui
urna setup का verify चरण, सारे checks पास
urna setup
engine

फ़ाइल और vector अंदर, hits बाहर। Python नहीं।

  • inspect
  • validate
  • stats
  • media
  • search
  • search-ann
  • search-graph
  • search-space
  • search-text
  • benchmark
  • cite
  • doctor
agent

टेक्स्ट या spec अंदर, citation वाले जवाब बाहर, offline Python embedder के ज़रिए।

  • ask
  • retrieve
  • build
setup

वह installer जिस पर हर चैनल ख़त्म होता है, और terminal explorer।

  • setup
  • tui
शुरू करने से पहले
पहली बार पढ़ते समय जो बातें अक्सर अटकाती हैं। बाक़ी docs में है, कमांड और आउटपुट के साथ
docs पढ़ें

आपका knowledge base, सफ़र के लिए तैयार

इंस्टॉल करें, corpus बनाएँ, फ़ाइल ऐप में कॉपी करें। बाक़ी काम mmap का है
इंस्टॉल करें
v0.5.1 · MIT · macOS, Linux और Windows