整个知识库,装进一个文件
 .csv.jsonl.sqlite
 .jpg
 Island
 Forest
 Mountain
一个文件夹加几行 TOML,变成一个 .urna:chunks、向量、索引、媒体和 manifest,每个段都有签名。
卡牌扫描图以 AV1 存进文件,向量换成更小的 preset。文件变小,引用保持不变。
model_hash 关卡核对模型,HNSW 沿图游走,BM25 匹配关键词,精确余弦决定顺序。
答案带着引用回到来源,urna validate 在第一次查询前离线核对每一层。
从一个文档文件夹
到一个能回答问题的文件



都装进一个 .urna






00100000 01010011 01111001 01110011 01110100 01100101 01101101 00111010 00100000 01000011 01100001 01110010 01100100 01110011


公开基准测试,同一把尺子


基准测试日期 2026-09-10,arm64,单线程。Urna 不做的事:原地更新和删除、元数据过滤、并发写入。 查看完整表格。
urna 基准测试
压缩与按名称搜索
7 个文件 · 每个 1,000 次查询是相对 3.98 GB 源 JPEG 的缩小倍数。crf50 档的文件为 533 MB,按名称找到卡牌的比例与 3.61 GB 的 lossless 文件相当:txt@1 相差 +0.001,在标准误差之内。
这个指标衡量什么
txt@1 是 1,000 次查询中正确卡牌排在第一位的比例。查询是卡牌名称的文本("artwork of the card {name}"),在 clip 的图像空间中搜索:模型只看得到卡图,所以每个文件的水平都很低;关键是它在哪里开始下降。
drift 是压缩图像的向量与原图向量之间的余弦:1.00 表示完全相同,值越低,codec 对模型所见内容的改动越大。最差十分位(p10)是变化最大的那 10% 卡牌边界上的那一张;中位数(p50)是居中的那一张。
如何阅读这张图
每一列是一个文件,包含同样的 38,627 张卡牌,从 lossless(3.61 GB)到 crf60 的 AV1(230 MB),按压缩程度排列。
上图中,两条 drift 线一路下降,从第二个文件起就跌破 gate floor。下图中,搜索效果到 crf50 为止保持平稳:绿色柱与 lossless 的差距在一个标准误差以内;虚线标出搜索开始下降的位置,红色柱是虚线之后的文件。
| 文件 | 大小 | drift p10 | txt@1 | ±1 标准误差 | z vs lossless |
|---|---|---|---|---|---|
| lossless | 3.61 GB | 0.9968 | 0.092 | 0.0091 | 0.00 |
| neardup | 1.37 GB | 0.9666 | 0.096 | 0.0093 | 0.31 |
| avif q48 | 1.2 GB | 0.9680 | 0.096 | 0.0093 | 0.31 |
| crf40 | 981 MB | 0.9594 | 0.089 | 0.0090 | -0.23 |
| crf50 | 533 MB | 0.9389 | 0.093 | 0.0092 | 0.08 |
| crf55 | 370 MB | 0.9211 | 0.074 | 0.0083 | -1.46 |
| crf60 | 230 MB | 0.8866 | 0.069 | 0.0080 | -1.89 |
每个文件 1,000 次查询,所有文件使用相同的卡牌;二项分布标准误差;z 是每个文件的 txt@1 与 lossless 之间以合并标准误差计的距离:到 crf50 为止,没有一个超过 1。
测于 2026-09-12 · benchmark/experiments/14-utility-ladder/results.json


curl -sSf https://raw.githubusercontent.com/hoffresearch/urna/main/scripts/install.sh | sh
urna setupurna build --spec corpus.tomlurna ask corpus.urna "离线能用吗?" -k 3urna retrieve corpus.urna "离线能用吗?" -k 5 --format jsonlimport urna
from urna.embed_potion import potion_embedder
emb, db = potion_embedder(), urna.open("corpus.urna")
qvec = emb.embed_texts(["离线能用吗?"])[0]
hits = db.retrieve(qvec, 5, expected_model_hash=emb.model_hash())urna validate corpus.urnaurna cite corpus.urna "urna://content_hash/chunk_id"urna benchmark corpus.urna -q 100 -k 10 --ann 100一次发布,所有包管理器


npx @urna/cli validate corpus.urnauvx --from urna urna validate corpus.urnacargo binstall urna三组子命令,外加一个操作界面
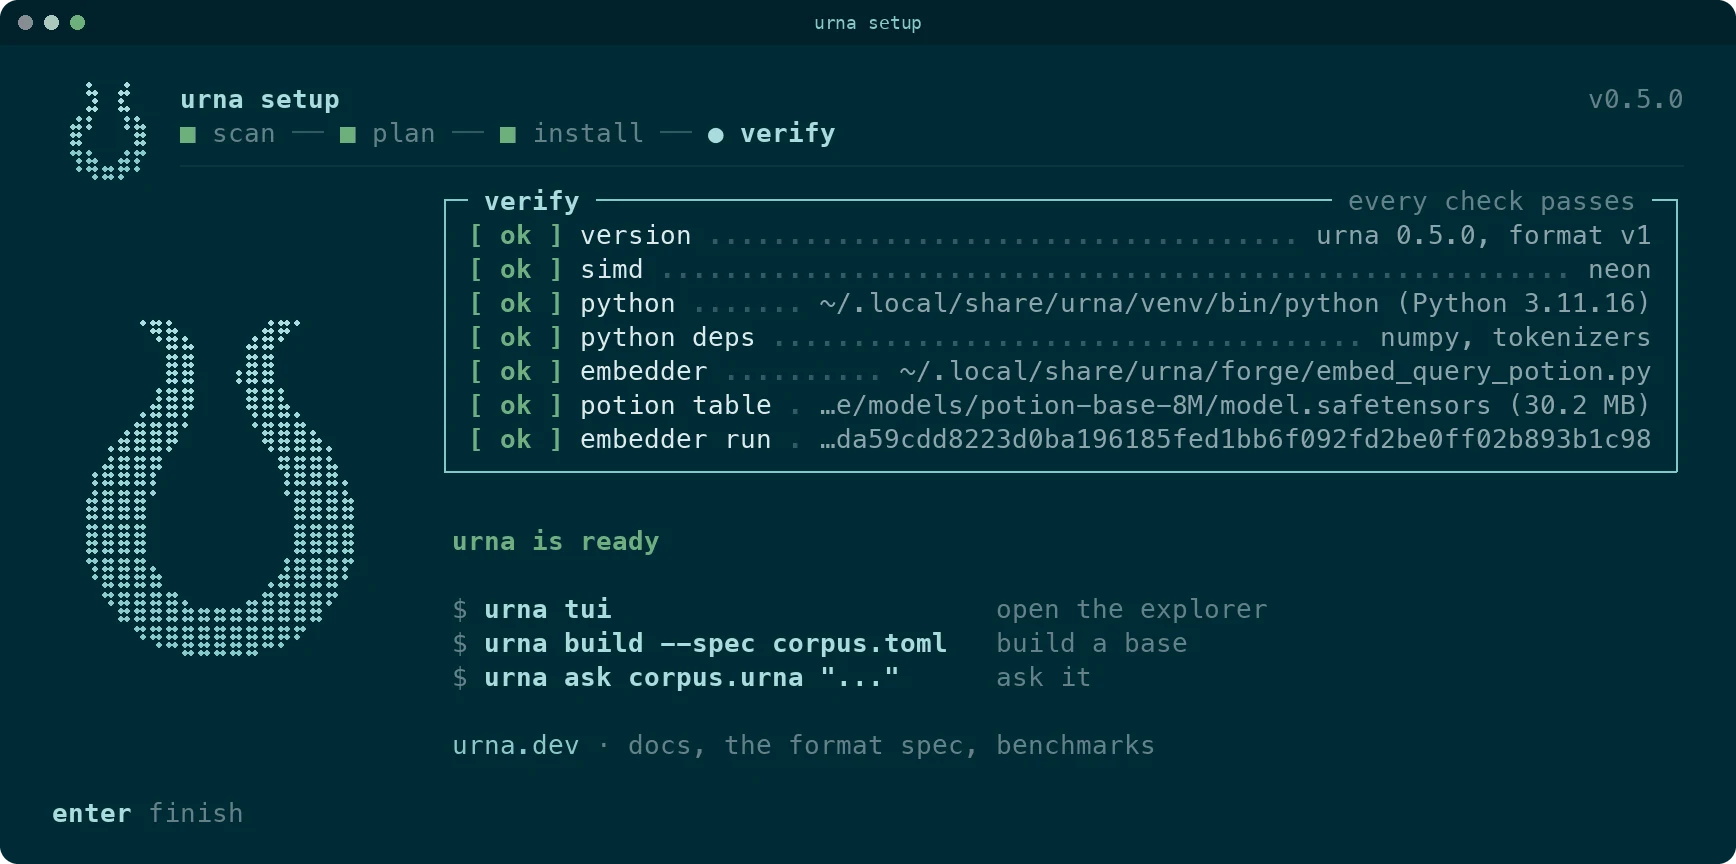
输入文件和向量,输出结果。不用 Python。
- inspect
- validate
- stats
- media
- search
- search-ann
- search-graph
- search-space
- search-text
- benchmark
- cite
- doctor
输入文本或 spec,输出带引用的答案,经由离线的 Python embedder。
- ask
- retrieve
- build
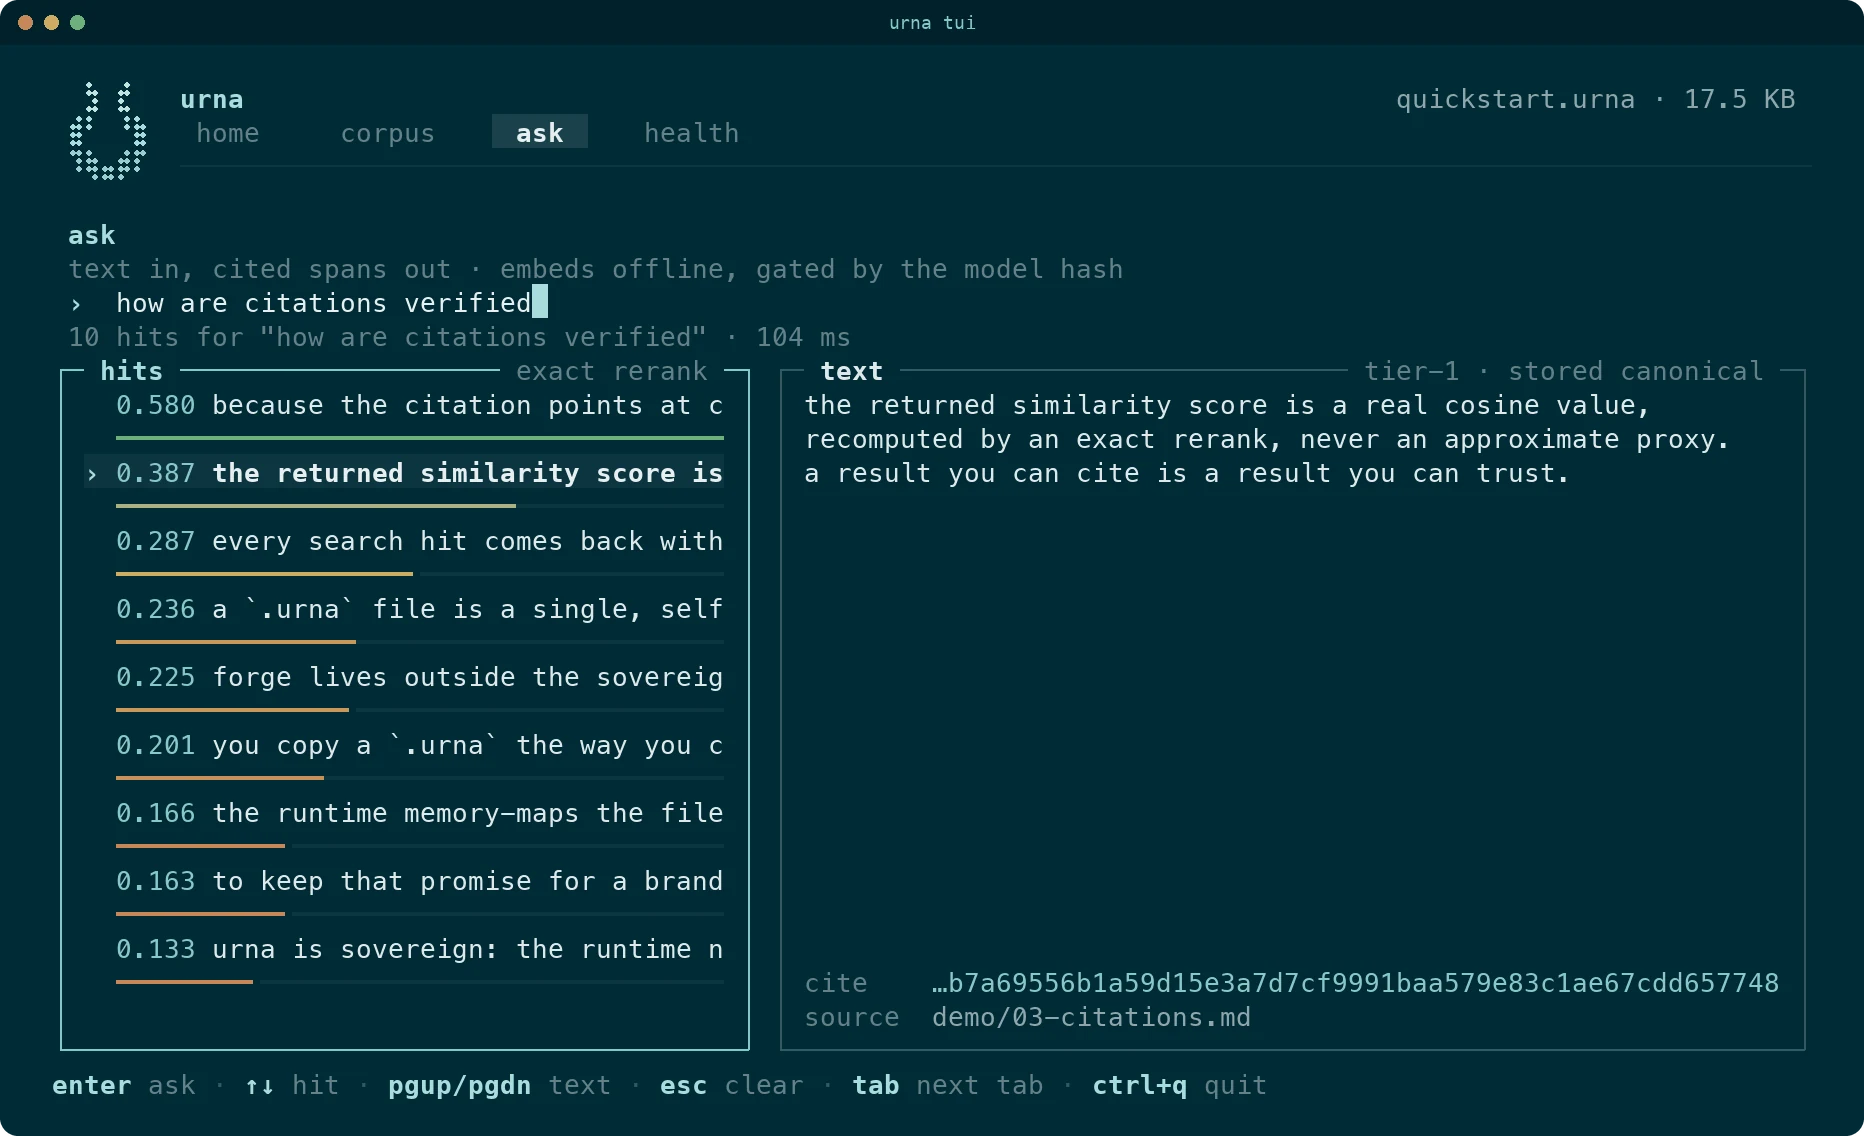
每个渠道最后都要运行的安装器,以及终端里的浏览器。
- setup
- tui