Toute la base de connaissances dans un seul fichier
 .csv.jsonl.sqlite
 .jpg
 Island
 Forest
 Mountain
Un dossier et quelques lignes de TOML deviennent un seul .urna : chunks, vecteurs, index, médias et manifest, chaque section signée.
Les scans des cartes entrent dans le fichier en AV1 et les vecteurs passent à un preset plus petit. Le fichier rétrécit, la citation reste la même.
Le gate model_hash vérifie le modèle, HNSW parcourt le graphe, BM25 trouve le mot et le cosinus exact fixe l'ordre.
La réponse porte une citation qui ramène à la source, et urna validate vérifie chaque couche avant la première requête, hors ligne.
D'un dossier de documents
à un fichier qui répond



Ce qui tient dans un .urna






00100000 01010011 01111001 01110011 01110100 01100101 01101101 00111010 00100000 01000011 01100001 01110010 01100100 01110011


Benchmark public, même étalon


Benchmark du 2026-09-10 sur arm64, un seul thread. Ce qu'Urna ne fait pas : mise à jour et suppression en place, filtres sur les métadonnées, écritures concurrentes. Voir le tableau complet.
Les benchmarks d'urna
Compression contre recherche par nom
7 fichiers · 1 000 requêtes chacunfois plus petit que les 3,98 GB de JPEG d'origine. Le fichier en crf50 pèse 533 MB et trouve la carte par son nom aussi souvent que le fichier lossless de 3,61 GB : txt@1 à +0,001, dans l'erreur type.
Ce que mesure cette métrique
txt@1 est la fraction des 1 000 requêtes où la bonne carte est arrivée en premier. La requête est le nom de la carte en texte ("artwork of the card {name}"), cherché dans l'espace image de clip : le modèle ne voit que l'illustration, d'où un niveau bas dans tous les fichiers ; ce qui compte, c'est l'endroit où il chute.
Le drift est le cosinus entre le vecteur de l'image compressée et celui de l'originale : 1,00 veut dire identique, et plus il descend, plus le codec a changé ce que voit le modèle. Le pire décile (p10) est la carte à la limite des 10 % qui ont le plus changé ; la médiane (p50) est la carte du milieu.
Comment lire ce graphique
Chaque colonne est un fichier avec les mêmes 38 627 cartes, du lossless (3,61 GB) à l'AV1 en crf60 (230 MB), par ordre de compression.
En haut, les deux lignes de drift descendent tout du long et passent sous le floor du gate dès le deuxième fichier. En bas, la recherche reste plate jusqu'à crf50 : les barres vertes sont à moins d'une erreur type du lossless ; la ligne pointillée marque l'endroit où la recherche chute, et les barres rouges sont les fichiers au-delà.
| fichier | taille | drift p10 | txt@1 | ±1 erreur type | z vs lossless |
|---|---|---|---|---|---|
| lossless | 3,61 GB | 0,9968 | 0,092 | 0,0091 | 0,00 |
| neardup | 1,37 GB | 0,9666 | 0,096 | 0,0093 | 0,31 |
| avif q48 | 1,2 GB | 0,9680 | 0,096 | 0,0093 | 0,31 |
| crf40 | 981 MB | 0,9594 | 0,089 | 0,0090 | -0,23 |
| crf50 | 533 MB | 0,9389 | 0,093 | 0,0092 | 0,08 |
| crf55 | 370 MB | 0,9211 | 0,074 | 0,0083 | -1,46 |
| crf60 | 230 MB | 0,8866 | 0,069 | 0,0080 | -1,89 |
1 000 requêtes par fichier, les mêmes cartes dans tous ; erreur type binomiale ; z est l'écart entre le txt@1 de chaque fichier et celui du lossless, en erreurs types combinées : jusqu'à crf50, aucun ne dépasse 1.
mesuré le 2026-09-12 · benchmark/experiments/14-utility-ladder/results.json


curl -sSf https://raw.githubusercontent.com/hoffresearch/urna/main/scripts/install.sh | sh
urna setupurna build --spec corpus.tomlurna ask corpus.urna "ça marche hors ligne ?" -k 3urna retrieve corpus.urna "ça marche hors ligne ?" -k 5 --format jsonlimport urna
from urna.embed_potion import potion_embedder
emb, db = potion_embedder(), urna.open("corpus.urna")
qvec = emb.embed_texts(["ça marche hors ligne ?"])[0]
hits = db.retrieve(qvec, 5, expected_model_hash=emb.model_hash())urna validate corpus.urnaurna cite corpus.urna "urna://content_hash/chunk_id"urna benchmark corpus.urna -q 100 -k 10 --ann 100Une release, tous les gestionnaires de paquets


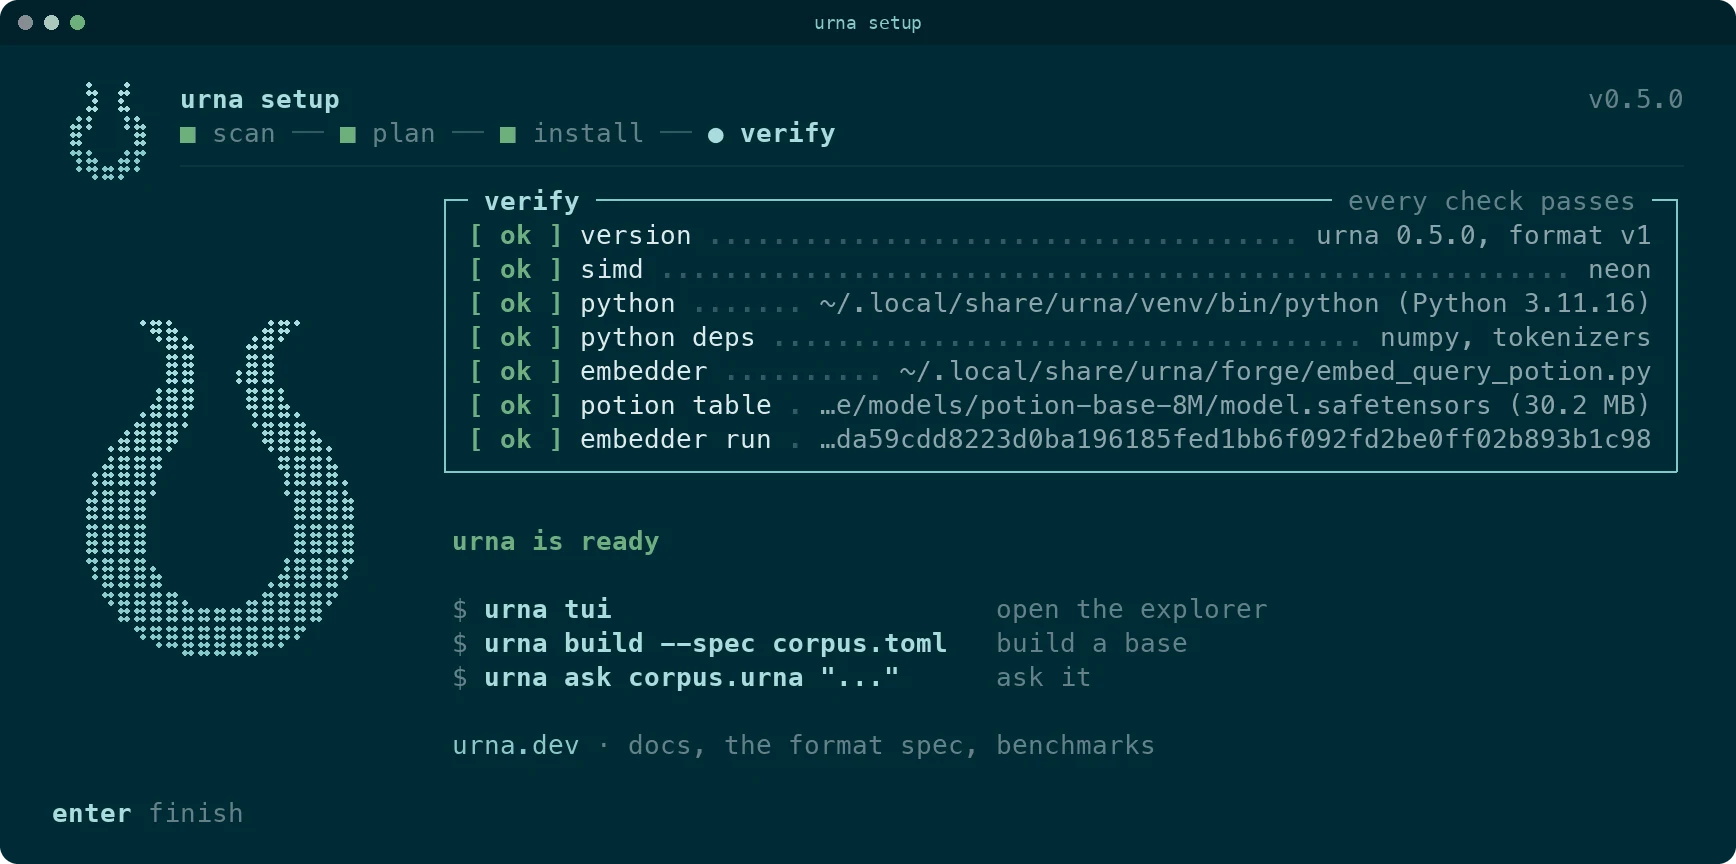
npx @urna/cli validate corpus.urnauvx --from urna urna validate corpus.urnacargo binstall urnaTrois groupes de verbes et un écran pour s'en servir
Un fichier et un vecteur en entrée, des résultats en sortie. Sans Python.
- inspect
- validate
- stats
- media
- search
- search-ann
- search-graph
- search-space
- search-text
- benchmark
- cite
- doctor
Du texte ou une spec en entrée, des réponses citées en sortie, via l'embedder Python hors ligne.
- ask
- retrieve
- build
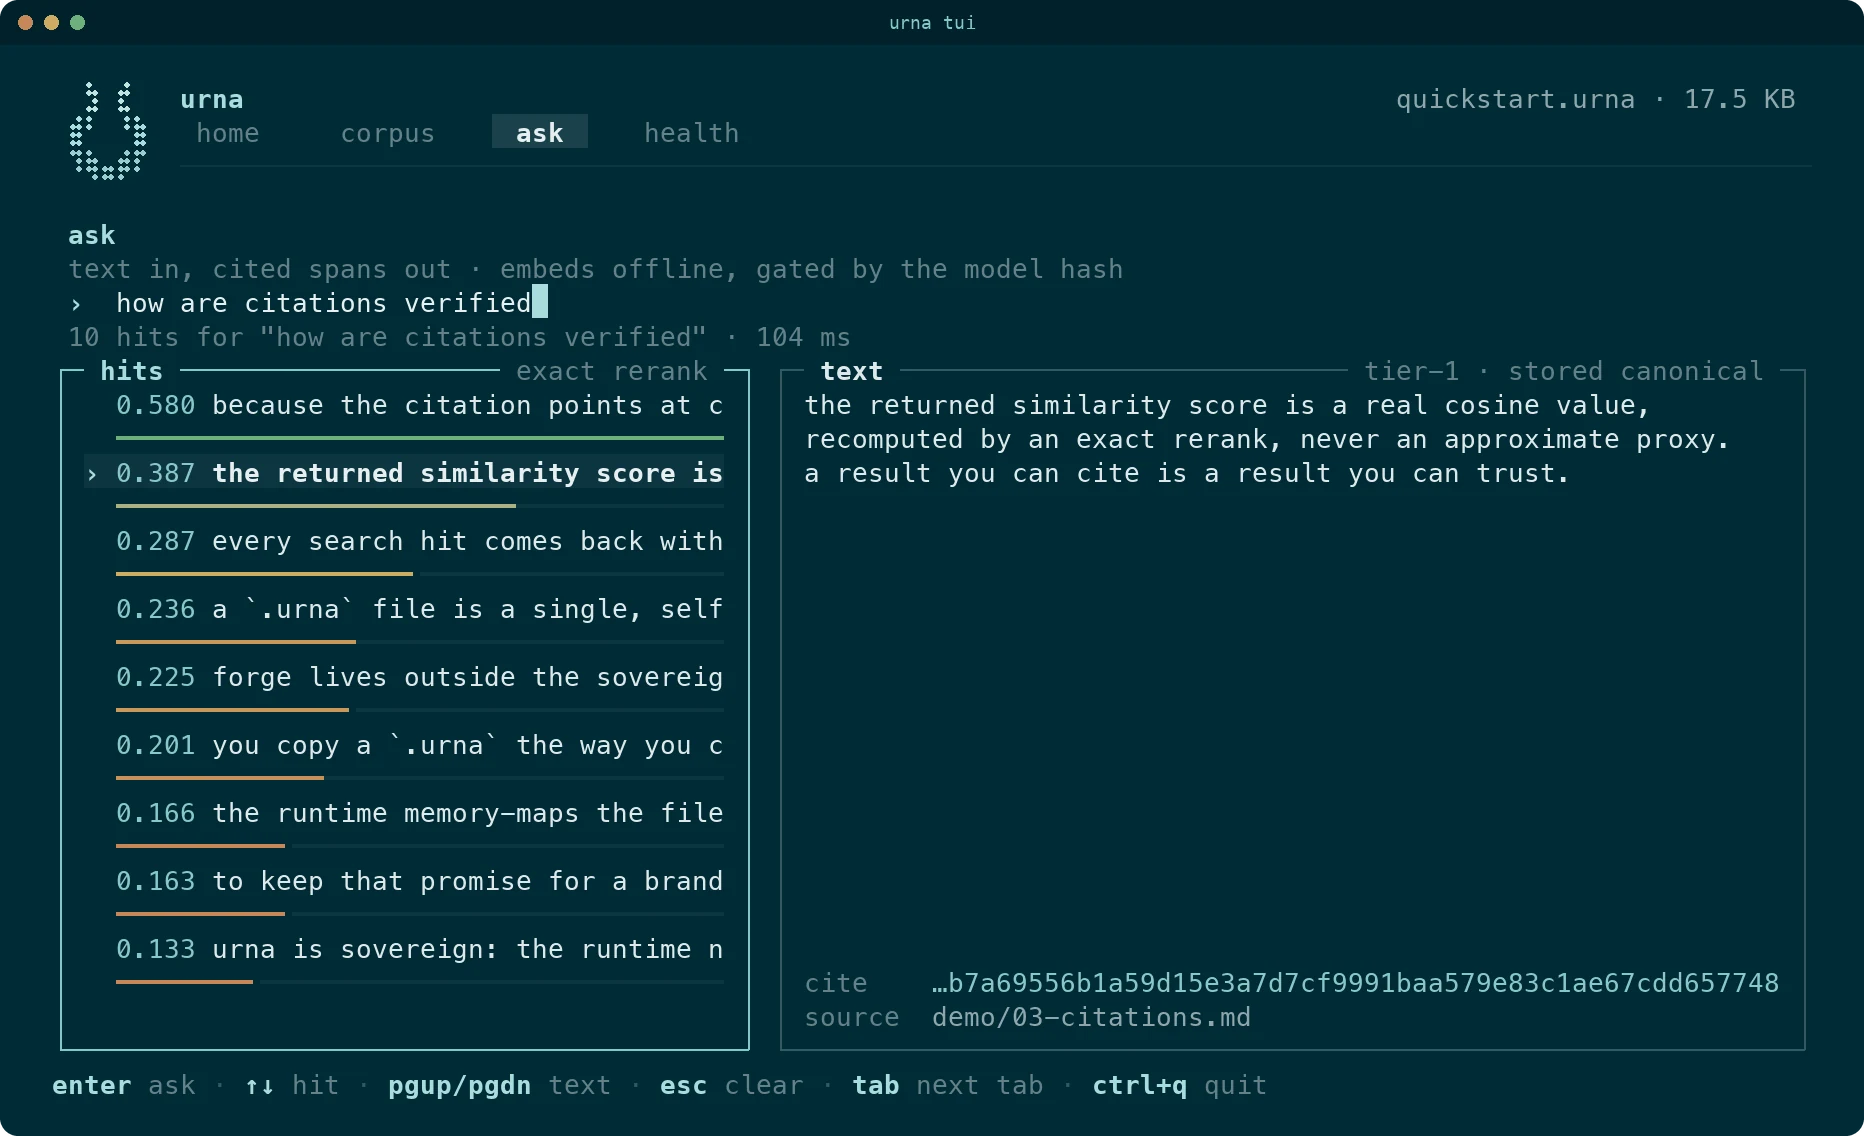
L'installeur par lequel finit chaque canal, et l'explorateur du terminal.
- setup
- tui